Thống kê ứng dụng trong nghiên cứu tâm lý
Tài liệu học thuật dùng trong chương trình. Nội dung giữ nguyên theo giáo trình gốc.
Mục lục (23 chương)
Mở đầu
EPSY205 • Giáo trình tự học có hướng dẫn • Dành cho Nancy
Nền tảng đại học và cầu nối đọc nghiên cứu ở bậc thạc sĩ
Phiên bản ngày 12/10/2026
Học qua dữ liệu, sơ đồ và tự giải thích. Mỗi chương đi từ câu hỏi đến lựa chọn phân tích, ví dụ có lời giải và bài chuyển giao. Cuối chương có sơ đồ đúc kết; cuối môn có bản đồ tổng hợp và bài đánh giá tích hợp.
Học liệu được biên soạn độc lập, tham chiếu nguồn từ Penn State, UCLA, MIT, OpenStax thuộc Rice University, APA, ASA và công trình của Daniël Lakens. Đây không phải giáo trình được các tổ chức đó chứng nhận, không quy đổi thành tín chỉ hoặc văn bằng. Để ôn đúng kỳ thi, cần đối chiếu thêm đề cương và dạng đề chính thức của trường bạn.
Toàn bộ dữ liệu, đề bài và các tình huống nhân sự, huấn luyện, học tập trong tài liệu là giả định do giáo trình xây dựng. Các con số nhỏ được chọn để làm rõ phép tính, không phải bằng chứng về hiệu quả thực tế.
Nội dung và đường đọc
Bấm vào tên phần để chuyển tới nội dung trong Word. Các tiêu đề cũng xuất hiện trong ngăn Dẫn hướng của ứng dụng đọc tài liệu.
Cách sử dụng và chuẩn đầu ra
Chương 1. Câu hỏi, biến và đơn vị phân tích
Chương 2. Mô tả dữ liệu và nhìn thấy ngoại lệ
Chương 3. Xác suất, phân phối lấy mẫu và sai số chuẩn
Chương 4. Khoảng tin cậy và độ chính xác
Chương 5. Kiểm định, p và sai lầm suy luận
Chương 6. Một mẫu và dữ liệu ghép cặp
Chương 7. Hai nhóm độc lập và kiểm định Welch
Chương 8. Nhiều nhóm, ANOVA và tương tác
Chương 9. Tương quan và hình dạng quan hệ
Chương 10. Hồi quy và kiểm tra phần dư
Chương 11. Tỷ lệ, bảng chéo và chi bình phương
Chương 12. Phương pháp thứ hạng, ngoại lệ và dữ liệu thiếu
Chương 13. Cỡ mẫu, nhiều kiểm định và chất lượng phép đo
Chương 14. Từ đầu ra phần mềm tới báo cáo có thể kiểm tra
Sơ đồ toàn môn và bảng chọn phương pháp
Bốn chuyên đề cầu nối thạc sĩ
Kiểm tra giữa môn và bài cuối môn
Đáp án, thang chấm và sửa lỗi
Bảng tra nhanh và thuật ngữ
Tài liệu tham khảo và đường đọc
Cách sử dụng và chuẩn đầu ra
Môn này giúp bạn làm được gì?
Sau EPSY165, bạn đã biết đặt câu hỏi và thiết kế nghiên cứu. EPSY205 giúp chuyển dữ liệu thành ước lượng có giới hạn. Năng lực đích là giải thích được vì sao chọn phép phân tích và kết luận nào được dữ liệu hỗ trợ, chứ không chỉ tìm một giá trị p.
V–Ad được triển khai như thế nào?
Trong tài liệu này, V–Ad là cách tổ chức theo sở thích của bạn: nhìn cấu trúc bằng sơ đồ rồi diễn đạt logic bằng lời. Đây là quy ước thiết kế học liệu, không phải khẳng định bạn thuộc một kiểu học cố định đã được kiểm định. Hiệu quả sẽ được kiểm tra bằng khả năng giải bài mới và nhớ sau một khoảng nghỉ.
Một phiên 40 phút: 5 phút nhớ lại không mở sách; 10 phút đọc khái niệm và ví dụ; 10 phút tự tính; 10 phút giải thích vì sao phương pháp phù hợp; 5 phút vẽ lại sơ đồ. Không nhìn sơ đồ khi vẽ lại. Sau đó đối chiếu và sửa mối nối còn thiếu.
Ôn vào ngày 1, 3, 7 và 14 sau khi học là lịch gợi ý, có thể điều chỉnh. Mỗi lần ôn cần có một bài trộn chương: ghép cặp hay độc lập, SD hay SE, liên hệ hay nhân quả. Luyện truy hồi, giãn cách và xen kẽ ví dụ với giải bài được tham chiếu hướng dẫn IES [S12]; lịch cụ thể ở đây do giáo trình đề xuất.
Lộ trình và đánh giá
Khối lượng tự học đề xuất: 90 giờ trong 15 tuần, khoảng 6 giờ mỗi tuần. Đây là kế hoạch cá nhân, không phải định nghĩa tín chỉ của trường. Mỗi tuần chia thành nhiều phiên 30–45 phút, có nghỉ giữa các phiên.
Tự đánh giá: bài tập chương 30%, bài giữa môn 20%, bài cuối môn 30%, báo cáo tích hợp 20%. Mốc 80/100 là tiêu chí học chắc do tài liệu đề xuất; không đại diện điểm đạt của trường. Dù tổng điểm cao, cần sửa các lỗi: coi p là xác suất giả thuyết đúng, coi tương quan là nhân quả, dùng quan sát lặp như người độc lập, và coi không có ý nghĩa thống kê là chứng minh không có tác động.
Đầu vào: hãy tự giải thích trung bình, tỷ lệ, biến phụ thuộc, lấy mẫu và phân nhóm ngẫu nhiên. Nếu chưa vững, quay lại EPSY165 và làm Chương 1–2 trước khi học kiểm định.
Chương 1. Câu hỏi, biến và đơn vị phân tích
Đích học và câu hỏi mở đầu
Bạn cần phân biệt tham số với thống kê, mô tả với suy luận, và nhận ra cấu trúc dữ liệu trước khi tính. Câu hỏi mở đầu: 16 nhân viên được đo hai lần tạo ra 32 dòng; nghiên cứu có 32 người độc lập không?
Nội dung cốt lõi
Tham số mô tả quần thể, thí dụ mức thay đổi trung bình của toàn bộ nhóm người mà nghiên cứu muốn hiểu. Thống kê được tính từ mẫu. Mẫu thuận tiện của một công ty có thể giúp mô tả công ty đó nhưng không tự đại diện cho mọi người lao động.
Biến định danh phân nhóm mà không có thứ tự; biến thứ bậc có thứ tự nhưng khoảng cách chưa chắc bằng nhau; biến định lượng biểu thị lượng đo có đơn vị. Một mục hài lòng từ 1 đến 5 thường mang tính thứ bậc. Điểm tổng nhiều mục có thể được phân tích như gần liên tục khi có cơ sở đo lường và kiểm tra phù hợp; không chỉ vì đã được mã bằng số.
Đơn vị lấy mẫu, phân nhóm, đo và phân tích có thể khác nhau. Nếu huấn luyện được phân ngẫu nhiên cho cả nhóm làm việc, nhân viên trong cùng nhóm có thể tương quan. Phân tích như tất cả độc lập làm sai độ bất định. Nhận diện này quan trọng hơn lựa chọn nút kiểm định trong phần mềm.
Bộ dữ liệu A–B dùng xuyên môn
Kết quả Y là số nhiệm vụ quan trọng hoàn tất trong 4 tuần, theo cùng quy tắc chất lượng. A là nhóm huấn luyện, B là nhóm đối chiếu. Giả định người tham gia được phân nhóm ngẫu nhiên ở cấp cá nhân và không có trao đổi can thiệp; đây là kịch bản minh họa, không phải dữ liệu thật. Δ = Sau − Trước. A1 và B1 là hai người khác nhau, không phải một cặp.
Thực hành và truy hồi
Lập từ điển gồm tên biến, định nghĩa, đơn vị, miền giá trị và mã thiếu. Đáp án mẫu: ID là định danh, không lấy trung bình; Δ là số nhiệm vụ, có thể âm; dữ liệu thiếu để trống có nhãn NA, không mã bằng 0. Có 16 người và 32 lần đo.
Bài chuyển giao: một lớp học có 20 học sinh, mỗi em làm 5 bài. Giải thích vì sao 100 điểm bài làm không tương đương 100 học sinh độc lập. Tự kiểm: các điểm thuộc cùng học sinh chia sẻ đặc điểm cá nhân; mô hình phải phản ánh cấu trúc đó.
Đọc bắt buộc: S01 để định vị học phần và S02 để xem cấu trúc câu hỏi chọn phép phân tích. Đừng chọn phép thử chỉ từ kiểu biến.
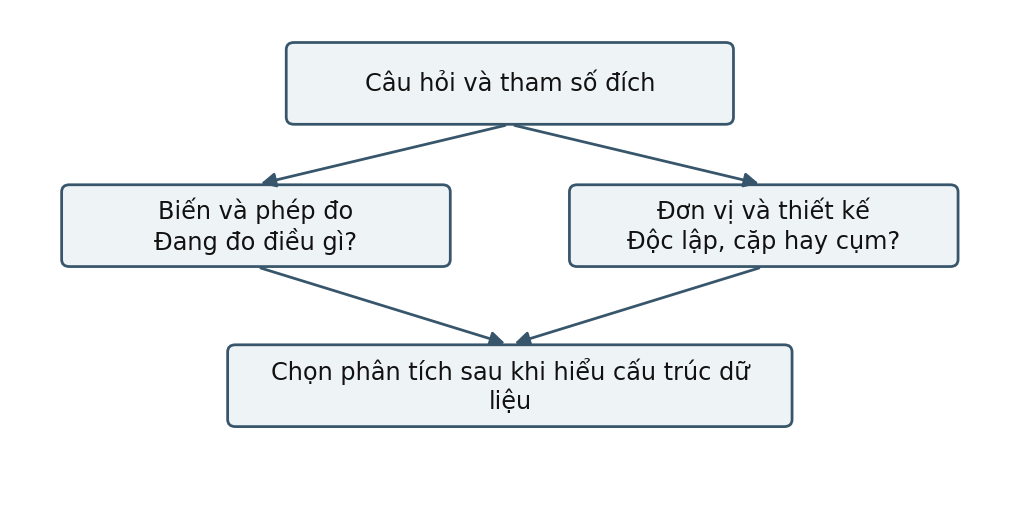
Hình 1. Sơ đồ đúc kết Chương 1, do giáo trình tổng hợp. Che hình, vẽ lại và giải thích mỗi mũi tên.
Chương 2. Mô tả dữ liệu và nhìn thấy ngoại lệ
Đích học
Tính được trung bình, trung vị, phương sai mẫu, SD; chọn biểu đồ phù hợp và giải thích được ảnh hưởng của ngoại lệ.
Khái niệm và ví dụ có lời giải
Trung bình cộng dùng tổng chia số quan sát; trung vị là vị trí giữa sau sắp xếp. SD mô tả độ phân tán trên đơn vị gốc. Phương sai mẫu lấy tổng bình phương độ lệch khỏi trung bình chia cho n − 1. Việc chia n − 1 liên quan tới ước lượng phương sai quần thể khi đã dùng dữ liệu ước lượng trung bình; không có nghĩa mọi đại lượng đều phải dùng n − 1.
Với ΔA = 2, 4, 3, 5, 1, 4, 6, 3: tổng 28 nên M = 3,50. Dãy đã sắp là 1, 2, 3, 3, 4, 4, 5, 6; trung vị = (3 + 4)/2 = 3,50. Tổng bình phương độ lệch là 18; phương sai s² = 18/7 = 2,571; SD = 1,604 nhiệm vụ.
Nếu 6 bị nhập thành 60, trung bình thành 10,25 trong khi trung vị vẫn 3,50. Trước khi xóa, cần kiểm tra bản ghi gốc: lỗi nhập liệu được sửa có nhật ký; giá trị thật khác thường cần được mô tả và phân tích độ nhạy. Không loại chỉ vì làm p tăng.
Histogram giúp nhìn hình dạng khi mẫu đủ; với n = 8, biểu đồ chấm giữ lại từng quan sát rõ hơn. Boxplot tóm tắt trung vị và tứ phân vị, nhưng quy ước tính tứ phân vị có thể khác giữa phần mềm. Khi báo cáo bài nhỏ, ghi quy ước nếu cần tái lập. Biểu đồ cột phù hợp số lượng hoặc tỷ lệ các nhóm, không thay thế đồ thị phân bố của biến liên tục.
Bài làm có giảm gợi ý
Với ΔB, hãy tự tính M và SD bằng cùng các bước. Gợi ý duy nhất: tổng là 6; tổng bình phương độ lệch quanh 0,75 là 7,50. Đáp án: M = 0,75; s² = 1,071; SD = 1,035. Viết một câu: “Trong 8 người nhóm B, mức thay đổi trung bình là 0,75 nhiệm vụ, SD = 1,04.” Chưa suy rộng ra quần thể.
Bài chuyển giao: thời gian phản ứng gồm 410, 420, 430, 440 và 1.800 ms. Tính trung bình 700 ms và trung vị 430 ms. Nêu lý do phải xem phân bố và quy tắc xử lý lỗi trước khi chọn chỉ số tóm tắt. Trung vị chống ảnh hưởng ngoại lệ tốt hơn nhưng không trả lời đúng cùng một đại lượng như trung bình.
Đọc bắt buộc: S03. Tự giải thích: “Mẫu có SD nhỏ” khác “trung bình được ước lượng chính xác” thế nào?
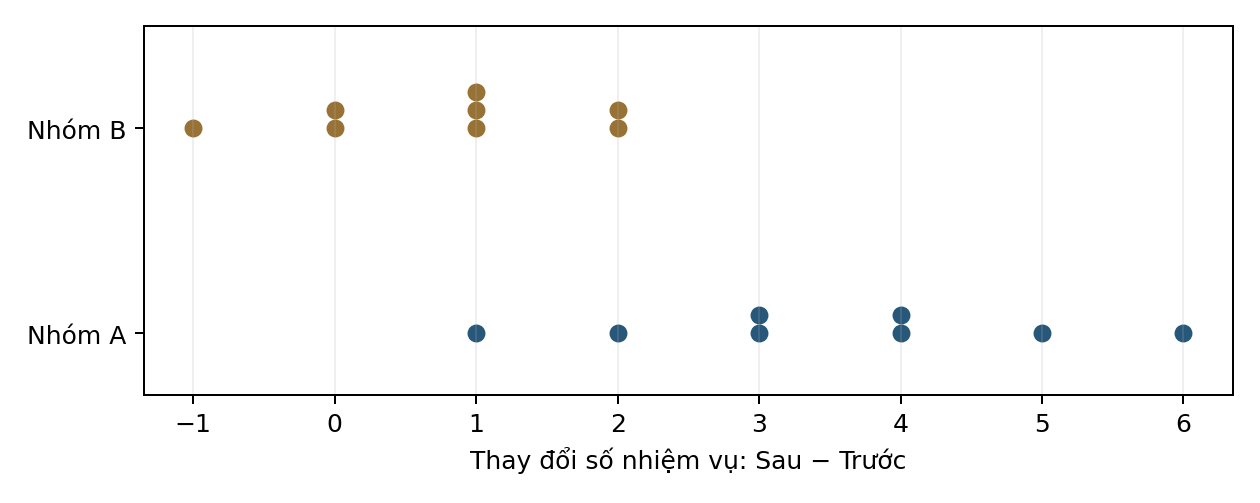
Hình thực hành A. Mỗi chấm là một người trong bộ A–B; chấm trùng được xếp lệch để nhìn rõ.
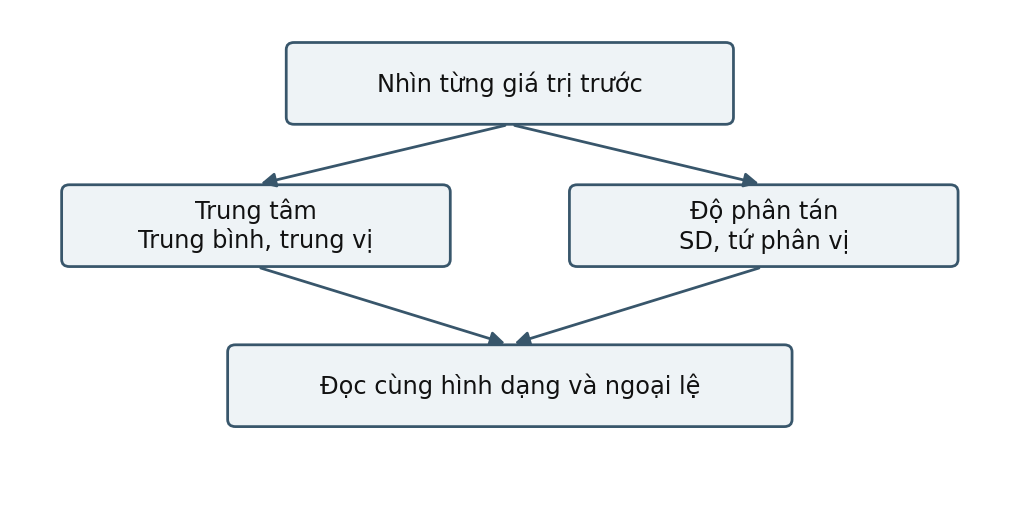
Hình 2. Sơ đồ đúc kết Chương 2, do giáo trình tổng hợp. Che hình, vẽ lại và giải thích mỗi mũi tên.
Chương 3. Xác suất, phân phối lấy mẫu và sai số chuẩn
Đích học
Phân biệt phân bố cá nhân với phân phối của thống kê qua các mẫu; dùng đúng SD và SE.
Từ cá nhân tới các mẫu
Hãy tưởng tượng lặp việc lấy mẫu n người từ cùng quần thể. Mỗi mẫu cho một trung bình; các trung bình này tạo thành phân phối lấy mẫu. Ta thường chỉ có một mẫu thực tế và dùng mô hình để ước lượng độ biến thiên giữa các trung bình có thể nhận được.
Nếu quan sát độc lập và phương sai hữu hạn, SE của trung bình được ước lượng bằng SD chia căn bậc hai của n. Với A: SE = 1,604/√8 = 0,567. SD = 1,604 nói về khác biệt giữa người; SE = 0,567 nói về độ bất định của trung bình theo mô hình lấy mẫu. Không thay SD bằng SE trong bảng mô tả mà không ghi rõ.
Định lý giới hạn trung tâm giải thích vì sao phân phối của trung bình có thể gần chuẩn khi n đủ lớn, ngay cả khi phân bố cá nhân không chuẩn, trong các điều kiện thích hợp. Không có ngưỡng n = 30 bảo đảm mọi trường hợp. Lệch nặng, ngoại lệ lớn, phụ thuộc hoặc phương sai không hữu hạn làm quy tắc đơn giản trở nên không đáng tin.
Chuẩn hóa z = (x − μ)/σ cho biết một quan sát cách trung bình quần thể bao nhiêu SD khi μ và σ đã biết. Ví dụ điểm có μ = 50, σ = 10 thì x = 65 có z = 1,5. Không cần giả định chuẩn để thực hiện phép biến đổi; muốn suy ra tỷ lệ diện tích từ bảng chuẩn phải có mô hình phân phối phù hợp.
Xác suất có điều kiện
Trong kịch bản giả định, 20% người tham gia bỏ học; trong số bỏ học, 60% báo bận công việc. Xác suất vừa bỏ học vừa báo bận là 0,20 × 0,60 = 0,12. Không thể đảo thành 60% người bận sẽ bỏ học nếu chưa biết tỷ lệ bận trong toàn mẫu. Việc đảo điều kiện tương tự cũng gây lỗi khi đọc p ở Chương 5.
Thực hành
Giữ SD = 10: n = 25 cho SE = 2; n = 100 cho SE = 1. Muốn SE giảm một nửa cần n tăng bốn lần theo mô hình này. Nhưng tăng n không tự sửa lấy mẫu thiên lệch.
Tự kiểm: dữ liệu của 100 nhân viên ở hai phòng ban có nhất thiết cho SE = SD/√100 không? Không: nếu có tương quan trong phòng, công thức độc lập có thể đánh giá thấp bất định.
Đọc bắt buộc: S04. Vẽ hai phân bố trong trí nhớ: các điểm cá nhân rộng, các trung bình mẫu hẹp hơn khi n tăng, với cùng tâm khi lấy mẫu không thiên lệch.
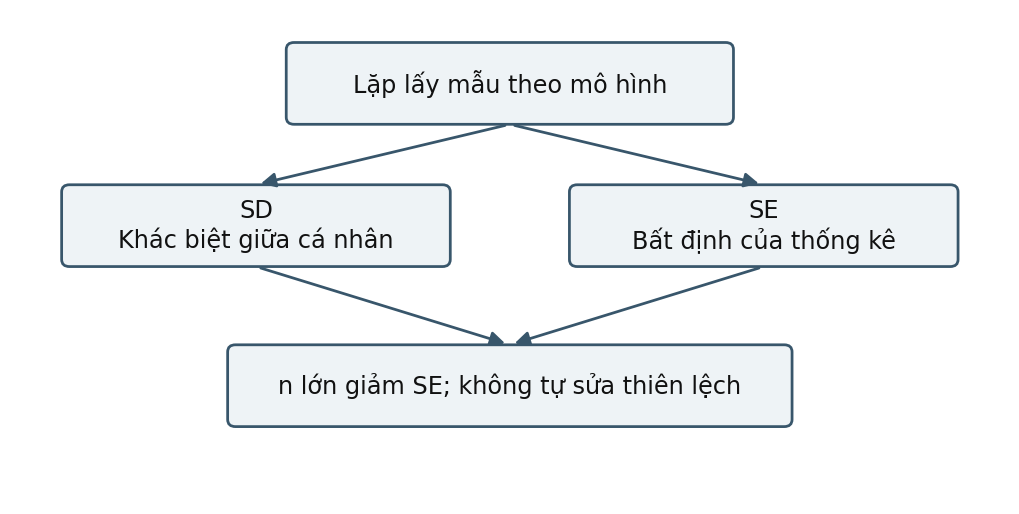
Hình 3. Sơ đồ đúc kết Chương 3, do giáo trình tổng hợp. Che hình, vẽ lại và giải thích mỗi mũi tên.
Chương 4. Khoảng tin cậy và độ chính xác
Đích học
Tính khoảng tin cậy t cho một trung bình; giải thích đúng mức tin cậy và so sánh độ rộng với nhu cầu thực tế.
Ví dụ đầy đủ
Khi σ chưa biết, dùng s để ước lượng SE và phân phối t với df = n − 1 trong mô hình một mẫu. Khoảng tin cậy 95% = trung bình mẫu ± t tới hạn × SE. Với A: n = 8, df = 7, t tới hạn = 2,365, M = 3,50 và SE = 0,567. Sai số biên = 1,341; khoảng tin cậy là [2,159; 4,841] nhiệm vụ.
Diễn giải thực hành: ước lượng mức thay đổi trung bình là 3,50, với khoảng tin cậy 95% từ 2,16 đến 4,84 theo mô hình. Nghĩa tần suất: nếu lặp quy trình lấy mẫu và lập khoảng, khoảng 95% các khoảng sẽ chứa tham số cố định khi các giả định đúng. Không phải 95% người có thay đổi trong khoảng này, cũng không phải xác suất 95% dành cho tham số trong một khoảng cố định theo cách diễn giải tần suất.
Điều kiện cần xem: độc lập giữa người, phép đo có ý nghĩa cho trung bình, và phân bố gần chuẩn khi mẫu nhỏ, không có ngoại lệ gây chi phối. Đối với thay đổi trước–sau, điều kiện phân bố áp dụng cho điểm thay đổi. Khoảng t không xử lý được thiên lệch đo hoặc mất mẫu có hệ thống.
Câu hỏi ra quyết định
Giả sử trước nghiên cứu đã thống nhất rằng tăng ít nhất 3 nhiệm vụ là mức đáng chi phí. Khoảng [2,16; 4,84] vượt 0 nhưng còn chứa giá trị dưới 3. Ta có thể có bằng chứng tăng trung bình mà vẫn chưa đủ chắc mức tăng vượt tiêu chí thực tế. Với chỉ nhóm A, đây còn chưa là hiệu quả can thiệp so với điều kiện đối chiếu.
Khoảng 99% rộng hơn khoảng 95% khi cùng dữ liệu và phương pháp. Khoảng hẹp hơn không luôn tốt hơn nếu được tạo ra bằng giả định sai hoặc bỏ quan sát bất lợi. Khoảng tin cậy cho trung bình khác khoảng dự đoán cho một người mới; dự đoán cá nhân thường phải tính thêm biến thiên giữa cá nhân.
Tự làm
Tính khoảng của B với M = 0,75, SE = 0,366 và t tới hạn = 2,365. Đáp án [−0,115; 1,615], làm tròn [−0,12; 1,62]. Khoảng chứa 0 không chứng minh thay đổi đúng bằng 0.
Đọc bắt buộc: S05. Hoàn thành câu: “Độ rộng khoảng phụ thuộc vào …”; cần nêu biến thiên, cỡ mẫu, mức tin cậy và cấu trúc/phương pháp ước lượng.
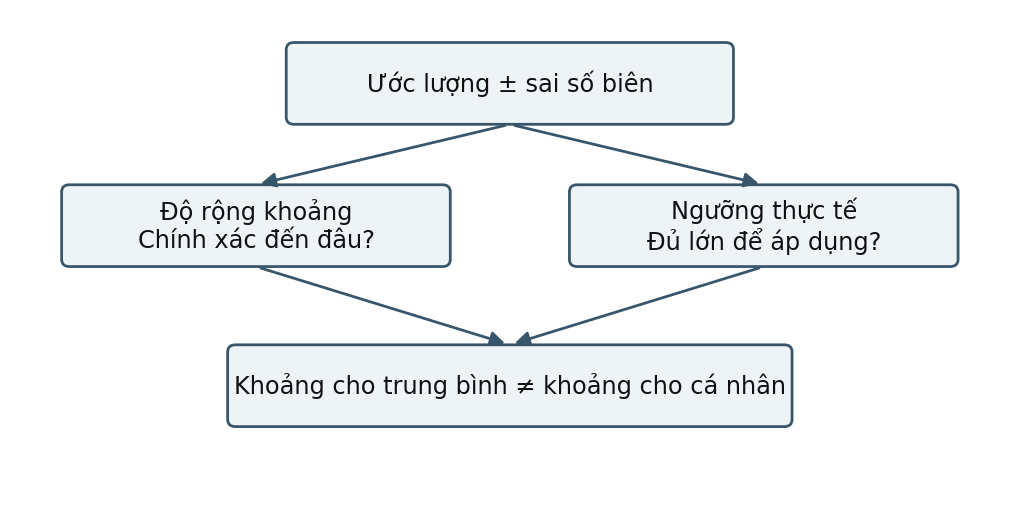
Hình 4. Sơ đồ đúc kết Chương 4, do giáo trình tổng hợp. Che hình, vẽ lại và giải thích mỗi mũi tên.
Chương 5. Kiểm định, p và sai lầm suy luận
Đích học
Xây dựng H0/H1, hiểu sai lầm loại I/II và tránh đọc p thành độ lớn tác động hay xác suất giả thuyết đúng.
Logic kiểm định
Giả thuyết không thường chỉ định một giá trị tham số, chẳng hạn mức thay đổi trung bình bằng 0. H1 hai phía là khác 0. p là xác suất nhận thống kê ít nhất cực đoan như đã quan sát, theo cách xác định độ cực đoan của kiểm định, khi H0 cùng các giả định mô hình đúng. Nó không phải xác suất H0 đúng sau khi thấy dữ liệu.
α là mức sai lầm loại I của quy trình: bác bỏ H0 khi H0 đúng. β là xác suất không bác bỏ H0 tại một giá trị thay thế xác định; power = 1 − β. Power phụ thuộc hiệu ứng giả định, biến thiên, n, α và thiết kế. Không có một power duy nhất cho mọi hiệu ứng.
Quy trình học: định trước câu hỏi và hướng kiểm định; xác định giả định; tính thống kê; đọc p cùng ước lượng và khoảng tin cậy; kết luận trong giới hạn thiết kế. Không chuyển từ hai phía sang một phía sau khi thấy kết quả để có p nhỏ hơn.
Đọc hai kết quả của bộ A–B
Kiểm định thay đổi bằng 0 trong A có p ≈ 0,000457; trong B có p ≈ 0,0796. Không thể từ “A có ý nghĩa, B không có ý nghĩa” kết luận hai nhóm khác nhau. Phải kiểm định trực tiếp chênh lệch A − B ở Chương 7. Hai phép kiểm định riêng trả lời hai câu hỏi khác với phép so sánh giữa nhóm.
ASA nhấn mạnh rằng kết luận không nên chỉ dựa vào việc vượt một ngưỡng p; p không đo độ lớn hoặc tầm quan trọng của tác động và cần báo cáo minh bạch [S06]. Trong tài liệu này, α = 0,05 chỉ là quy ước cho bài tập, không phải ranh giới tự nhiên giữa đúng và sai.
Sửa lỗi
Câu sai: “p = 0,03 nghĩa là 97% khả năng huấn luyện có tác dụng.” Câu sửa: “Dữ liệu không phù hợp lắm với H0 theo kiểm định đã chọn; cần xem ước lượng, khoảng tin cậy, thiết kế và giả định trước khi kết luận.”
Câu sai: “p = 0,20 chứng minh hai cách tương đương.” Câu sửa: “Chưa có đủ bằng chứng bác bỏ H0; muốn đánh giá tương đương phải định trước biên tương đương và dùng phương pháp phù hợp.”
Bài truy hồi: vẽ bảng H0 đúng/sai × bác bỏ/không bác bỏ và điền sai lầm loại I, II. Đáp án: loại I ở ô H0 đúng/bác bỏ; loại II ở ô H0 sai/không bác bỏ. Đọc bắt buộc: S06.
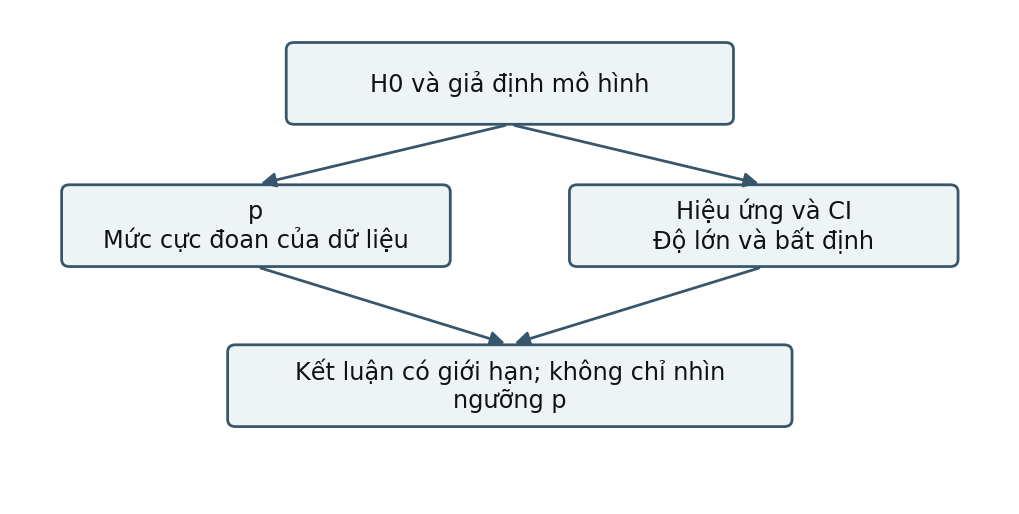
Hình 5. Sơ đồ đúc kết Chương 5, do giáo trình tổng hợp. Che hình, vẽ lại và giải thích mỗi mũi tên.
Chương 6. Một mẫu và dữ liệu ghép cặp
Đích học
Tính kiểm định t ghép cặp từ điểm chênh lệch, báo cáo hiệu ứng và nhận ra giới hạn của nghiên cứu trước–sau.
Cấu trúc quyết định phương pháp
Cùng một người đo hai thời điểm tạo cặp. Ta chuyển hai cột thành một cột d = Sau − Trước rồi kiểm định trung bình d so với giá trị đã định, thường là 0. Hai tập điểm trước và sau không phải hai mẫu độc lập. Một thiết kế ghép người cũng có thể tạo cặp nếu có quy tắc ghép thật; trùng số thứ tự không đủ.
Thống kê t = (trung bình d − giá trị theo H0)/SE của trung bình d. Với A, t = 3,50/0,567 = 6,173; df = 7; p hai phía ≈ 0,000457. Khoảng 95% [2,16; 4,84] là khoảng đã tính ở Chương 4. Các phép tính này cũng là t một mẫu áp dụng lên d.
Độ lớn hiệu ứng chuẩn hóa cho ghép cặp ở đây là d_z = trung bình d/SD của d = 3,50/1,604 = 2,183. Đây là d_z, không được gọi chung chung rồi so trực tiếp với Cohen d giữa nhóm. Mẫu minh họa nhỏ tạo hiệu ứng rất lớn có chủ ý để dễ tính; không suy ra hiệu quả huấn luyện ngoài thực tế.
Viết báo cáo
“Ở 8 người nhóm A, số nhiệm vụ hoàn tất tăng trung bình 3,50 (SD của thay đổi = 1,60), khoảng tin cậy 95% [2,16; 4,84]; t(7) = 6,17, p < 0,001, d_z = 2,18.” Sau đó thêm: “Phân tích trong một nhóm không tách được ảnh hưởng của thời gian, luyện tập hay các thay đổi đồng thời khỏi ảnh hưởng can thiệp.”
Kiểm tra trước khi dùng: mỗi cặp đúng ID; d không bị ngoại lệ nghiêm trọng; các người độc lập theo thiết kế; mất một thời điểm được ghi rõ. Phân tích cặp hoàn chỉnh chỉ dùng người có đủ hai lần đo, và có thể thiên lệch khi mất dữ liệu liên quan kết quả.
Tự làm và chuyển giao
Thực hiện cho B: t(7) = 2,049; p = 0,0796; d_z = 0,725; CI như Chương 4. Trường hợp này cho thấy hiệu ứng chuẩn hóa tương đối lớn trong mẫu vẫn có thể đi cùng bất định đáng kể.
Bài chuyển giao: 25 sinh viên được đo giấc ngủ trước và sau kỳ thi. Bạn có thể báo cáo thay đổi, nhưng không kết luận chỉ kỳ thi gây thay đổi vì không có đối chiếu phù hợp. Đọc bắt buộc: S07 và phần một mẫu của S08.
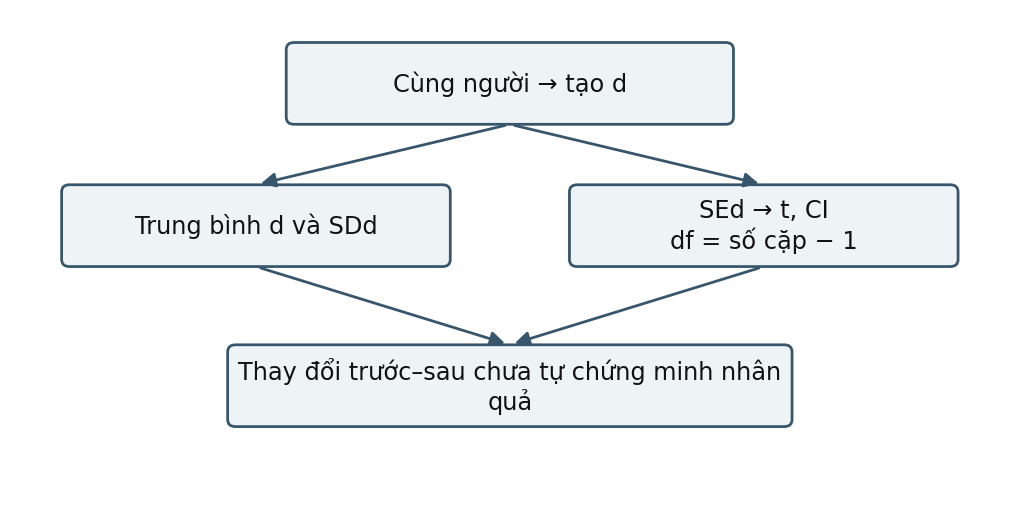
Hình 6. Sơ đồ đúc kết Chương 6, do giáo trình tổng hợp. Che hình, vẽ lại và giải thích mỗi mũi tên.
Chương 7. Hai nhóm độc lập và kiểm định Welch
Đích học
Ước lượng chênh lệch giữa hai nhóm, hiểu SE của chênh lệch và phân biệt phân tích giữa nhóm với trong nhóm.
Ví dụ xuyên môn
Tham số đích ở đây là chênh lệch mức thay đổi trung bình A − B. Ước lượng = 3,50 − 0,75 = 2,75 nhiệm vụ. Hai cột Δ của A và B độc lập theo kịch bản; từng Δ đã xử lý cặp trước–sau bên trong người.
Welch không yêu cầu hai quần thể có phương sai bằng nhau. SE chênh lệch = √(sA²/nA + sB²/nB) = √(2,571/8 + 1,071/8) = 0,675. t = 2,75/0,675 = 4,075. Bậc tự do Welch–Satterthwaite xấp xỉ 11,97, thường không nguyên. Phần mềm tính df từ hai phương sai và hai cỡ mẫu; không tự thay bằng 14 như t gộp.
Kết quả: p hai phía = 0,001547; CI 95% cho A − B là [1,279; 4,221]. Báo cáo: “Mức thay đổi của A cao hơn B trung bình 2,75 nhiệm vụ, CI 95% [1,28; 4,22], t(11,97) = 4,08, p = 0,002.” Làm tròn p khi báo cáo khác với giữ đầy đủ chữ số trong tính toán.
Có thể bổ sung hiệu ứng chuẩn hóa nếu ghi mẫu số. Với SD gộp mô tả bằng 1,350, Cohen d ≈ 2,038. Hedges g hiệu chỉnh xấp xỉ J = 1 − 3/(4×14 − 1) cho g ≈ 1,926. Không dùng các mốc nhỏ/vừa/lớn thay cho đánh giá giá trị thực tế; chênh lệch thô 2,75 nhiệm vụ thường dễ hiểu hơn. Dùng Welch cho suy luận vẫn có thể báo cáo d theo SD gộp, nhưng phải nói rõ định nghĩa.
Giả định và giới hạn
Welch vẫn cần độc lập, dữ liệu phù hợp ước lượng trung bình và không có ngoại lệ chi phối; mẫu n = 8 mỗi nhóm khiến suy luận nhạy với hình dạng phân bố. Với điểm đếm nhỏ như bài này, đây là minh họa xấp xỉ; phân tích thực tế có thể cần mô hình đếm hoặc kiểm tra độ nhạy thích hợp.
Phân nhóm ngẫu nhiên hỗ trợ suy luận nhân quả nếu thực hiện, tuân thủ và mất mẫu được xử lý phù hợp. Mẫu nhỏ, một bối cảnh và nhiệm vụ giả lập vẫn hạn chế khái quát. Nếu phân nhóm tự chọn, báo cáo liên hệ giữa nhóm và thay đổi, không khẳng định hiệu quả nhân quả.
Tự kiểm: tại sao ghép A1 với B1 là sai? Vì không có quy tắc ghép trong thiết kế. Vì sao không chọn phép thử chỉ sau Levene? Vì phương pháp cần dựa vào câu hỏi, thiết kế và độ vững, không chỉ một kiểm định tiền đề. Đọc bắt buộc: S09; xem S02 cho đối chiếu lựa chọn.
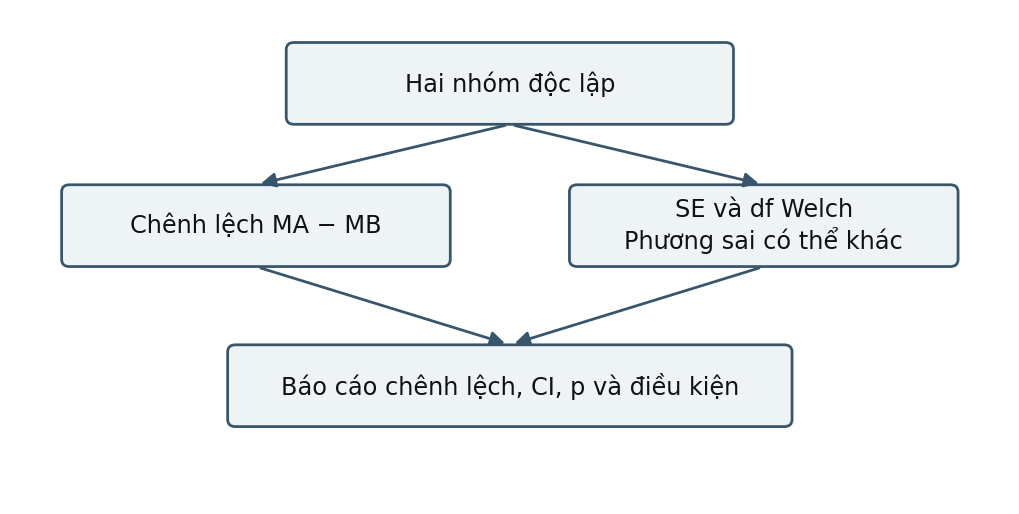
Hình 7. Sơ đồ đúc kết Chương 7, do giáo trình tổng hợp. Che hình, vẽ lại và giải thích mỗi mũi tên.
Chương 8. Nhiều nhóm, ANOVA và tương tác
Đích học
Hiểu tỷ số F, tính ANOVA một yếu tố trong ví dụ nhỏ và phân biệt hiệu ứng chính với tương tác.
Ví dụ tính từng bước
Ba phương pháp học giả định có điểm nhớ lại: X = 2, 3, 4, 3; Y = 4, 5, 6, 5; Z = 6, 7, 8, 7. Trung bình nhóm lần lượt 3, 5, 7; trung bình chung 5. H0: ba trung bình quần thể bằng nhau. H1: ít nhất một trung bình khác; không phải tất cả đều khác nhau.
Tổng bình phương giữa nhóm = 4×(3−5)² + 4×(5−5)² + 4×(7−5)² = 32. Tổng bình phương trong nhóm = 2 + 2 + 2 = 6. Tổng là 38. df giữa nhóm = 3−1 = 2; df trong nhóm = 12−3 = 9. Bình phương trung bình giữa = 16; trong = 6/9 = 0,667. F = 16/0,667 = 24,00, p ≈ 0,000247.
η² = SS giữa/SS tổng = 32/38 = 0,842. Đây là tỷ phần biến thiên trong mẫu gắn với phân nhóm, không chứng minh 84,2% trí nhớ do phương pháp gây ra. Ước lượng hiệu ứng có thể lạc quan ở mẫu nhỏ.
Điều kiện và câu hỏi tiếp theo
ANOVA cổ điển giả định sai số độc lập, gần chuẩn trong nhóm và phương sai bằng nhau. Khi phương sai không bằng nhau, cân nhắc Welch ANOVA; kiểm tra cấu trúc và ngoại lệ trước. Nếu ANOVA cho bằng chứng khác biệt, muốn biết cặp nào khác phải dùng so sánh được định trước hoặc hậu kiểm có kiểm soát bội, thí dụ Tukey khi điều kiện phù hợp. Không chạy nhiều t-test rồi chỉ giữ cặp có p nhỏ.
ANOVA hai yếu tố xét cả tương tác: tác động của một yếu tố thay đổi theo mức yếu tố kia. Ví dụ điểm trung bình dưới phương pháp thông thường/huấn luyện ở người mới là 4/8, ở người có kinh nghiệm là 7/8. Chênh lệch tương ứng 4 và 1, nên tương tác mô tả là 3. Chỉ các trung bình này chưa đủ kết luận tương tác có ý nghĩa; cần độ biến thiên, n và mô hình.
Tự làm: giải thích vì sao p của ANOVA không chỉ ra nhóm Z tốt hơn cả X và Y. Đáp án: kiểm định chung bác bỏ sự bằng nhau toàn bộ; chưa định vị từng cặp. Bài chuyển giao: nếu cùng người thử cả ba phương pháp, ANOVA độc lập trên không còn phù hợp; phải phản ánh đo lặp và thứ tự thực hiện.
Đọc bắt buộc: S10, bài giảng MIT về logic ANOVA. Ví dụ số và bảng trên do giáo trình xây dựng.
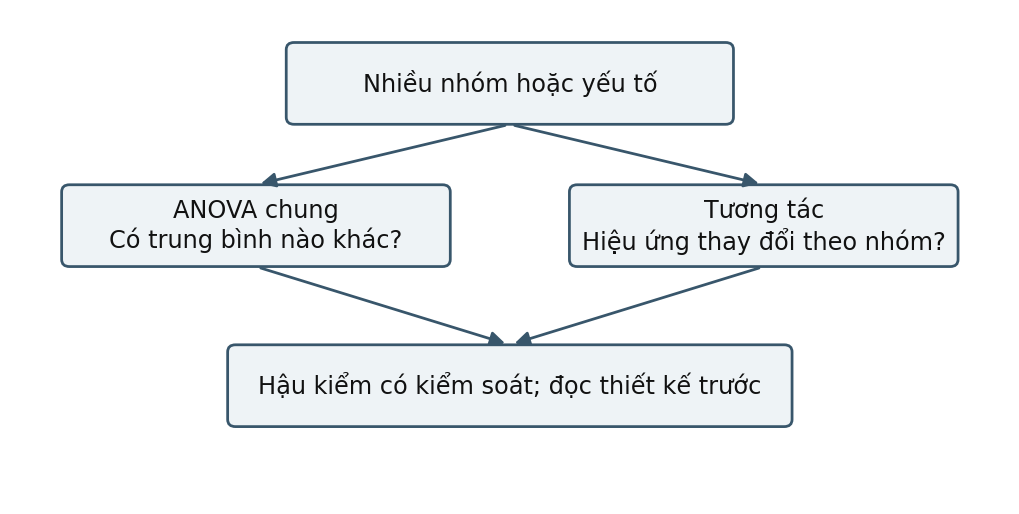
Hình 8. Sơ đồ đúc kết Chương 8, do giáo trình tổng hợp. Che hình, vẽ lại và giải thích mỗi mũi tên.
Chương 9. Tương quan và hình dạng quan hệ
Đích học
Diễn giải Pearson r, phân biệt liên hệ tuyến tính và đơn điệu, không suy nhân quả từ tương quan.
Ví dụ và cách đọc
Bộ C giả định gồm số phiên luyện tập X = 1, 2, 3, 4, 5, 6 và điểm nhớ lại Y = 3, 4, 4, 6, 5, 8. Vẽ scatterplot trước. Pearson r chuẩn hóa đồng biến thiên bằng độ phân tán của hai biến; r nằm từ −1 đến 1 khi cả hai có phương sai khác 0. Trong C, tổng tích độ lệch là 15, tổng bình phương độ lệch của X là 17,5, của Y là 16; r = 15/√(17,5×16) = 0,896.
r dương nghĩa là X lớn thường đi cùng Y lớn trong quan hệ tuyến tính; không có nghĩa mọi cá nhân đều theo đúng đường. r² ≈ 0,804 trùng R² của hồi quy tuyến tính đơn có hệ số chặn trên cùng dữ liệu. Không diễn giải đây là 80,4% trí nhớ được gây ra bởi luyện tập.
Để kiểm định Pearson r = 0 theo mô hình chuẩn hai biến và quan sát độc lập, dùng t = r√((n−2)/(1−r²)), df = n−2. Với C: t ≈ 4,045, df = 4, p ≈ 0,0155. n rất nhỏ nên một điểm có thể ảnh hưởng mạnh; mô hình kiểm định không được bảo đảm chỉ vì r lớn.
Spearman dùng thứ hạng, phù hợp để mô tả quan hệ đơn điệu và dữ liệu thứ bậc. Nó không phát hiện mọi quan hệ phi tuyến: dạng chữ U có thể cho tương quan gần 0 dù liên hệ rất rõ. Việc đổi Pearson sang Spearman thay đổi điều được tóm tắt, không chỉ là nút “sửa dữ liệu không chuẩn”.
Phản biện và bài tập
Hai người có nhiều thời gian rảnh có thể vừa luyện tập nhiều vừa đạt điểm cao; thời gian rảnh là một giải thích khác. Chiều ngược cũng có thể có: người học tốt chọn luyện nhiều. Tương quan không tự phân biệt các khả năng này.
Tự làm: X = −2, −1, 0, 1, 2 và Y = 4, 1, 0, 1, 4. Pearson r = 0, nhưng đồ thị chữ U cho thấy quan hệ có cấu trúc. Vì vậy câu “không tương quan tuyến tính” chính xác hơn “không có quan hệ”.
Bài chuyển giao: khảo sát tự báo cáo hỗ trợ của quản lý và gắn kết có r = 0,70. Nêu ba giới hạn: chung phương pháp đo, yếu tố thứ ba, và thời điểm cắt ngang không xác lập thứ tự thời gian. Đọc bắt buộc: S11a để nối từ tương quan sang hồi quy.
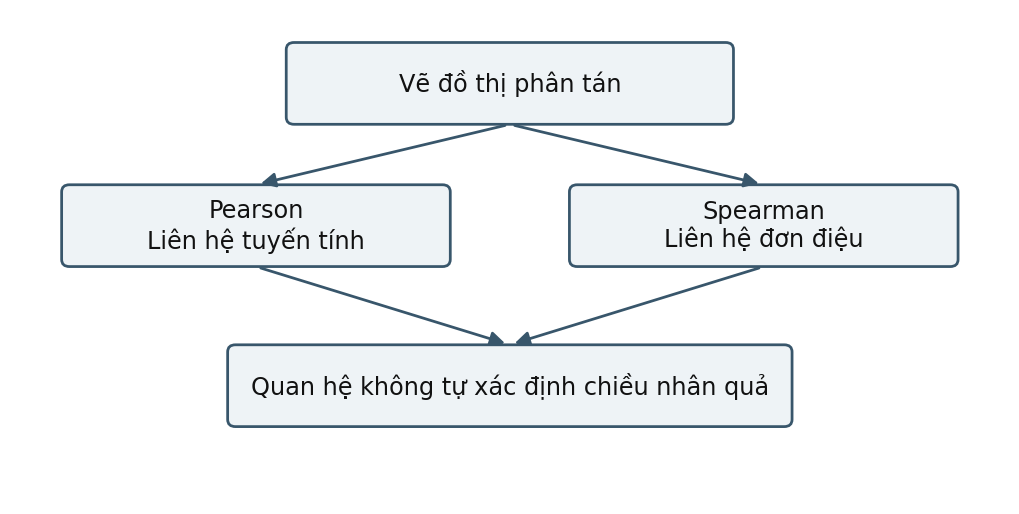
Hình 9. Sơ đồ đúc kết Chương 9, do giáo trình tổng hợp. Che hình, vẽ lại và giải thích mỗi mũi tên.
Chương 10. Hồi quy và kiểm tra phần dư
Đích học
Diễn giải hệ số, dự đoán trong miền dữ liệu và nhận ra giả định của mô hình hồi quy.
Từ dữ liệu tới đường dự đoán
Hồi quy tuyến tính đơn biểu diễn trung bình có điều kiện của Y theo X bằng đường thẳng và sai số. Với bộ C, hệ số dốc b = 15/17,5 = 0,857; hệ số chặn a = 5 − 0,857×3,5 = 2. Phương trình dự đoán: Ŷ = 2 + 0,857X.
X tăng một phiên gắn với điểm dự đoán trung bình tăng khoảng 0,857, trong phạm vi dữ liệu và mô hình. Hệ số chặn 2 là dự đoán tại X = 0, nhưng dữ liệu quan sát bắt đầu từ 1; ý nghĩa thực tiễn của điểm 0 cần xem riêng. X = 4 cho Ŷ = 5,429; Y thực tế là 6 nên phần dư = 0,571. Không dùng phương trình này để khẳng định người luyện 30 phiên sẽ đạt 27,71 điểm: đó là ngoại suy rất xa.
Sai số chuẩn của b = 0,212. Với df = 4, CI 95% của b xấp xỉ [0,269; 1,445]. Ước lượng dốc dương nhưng còn bất định rộng. R² = 0,804 là mức giảm tổng bình phương sai lệch khi dùng đường hồi quy so với chỉ dùng trung bình Y, trong mẫu này.
Kiểm tra giả định bằng câu hỏi
Giả định chuẩn của hồi quy liên quan sai số có điều kiện, không yêu cầu riêng X và Y đều phân phối chuẩn. Một kiểm định chuẩn không đủ để xác nhận toàn bộ mô hình [S11b].
Cầu nối hồi quy đa biến
Thêm điểm ban đầu và nhóm vào mô hình điểm sau cho phép ước lượng liên hệ có điều chỉnh. Tuy nhiên “đã kiểm soát nhiều biến” không bảo đảm nhân quả: có thể còn nhiễu chưa đo, đo sai hoặc điều chỉnh biến trung gian/biến gây sai lệch. Chọn biến cần lý thuyết và thiết kế, không chỉ dựa p.
Tự làm: X = 5 thì Ŷ = 6,286; phần dư với Y = 5 là −1,286. Giải thích bằng lời dấu âm: kết quả quan sát thấp hơn dự đoán. Đọc bắt buộc: S11a–S11b.
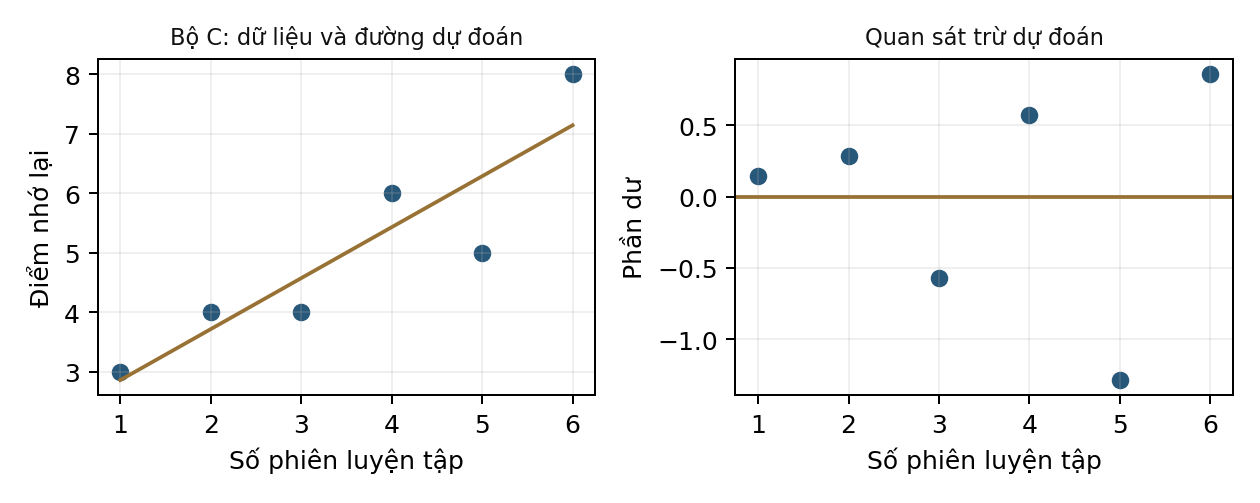
Hình thực hành B. Bộ C và phần dư từ Ŷ = 2 + 0,857X. Sáu điểm chỉ minh họa, không đủ xác nhận mô hình.
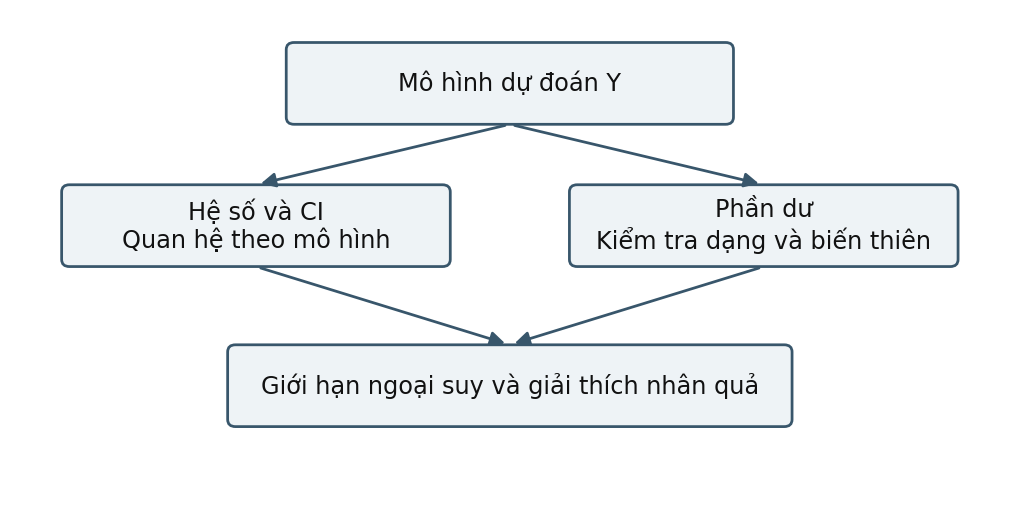
Hình 10. Sơ đồ đúc kết Chương 10, do giáo trình tổng hợp. Che hình, vẽ lại và giải thích mỗi mũi tên.
Chương 11. Tỷ lệ, bảng chéo và chi bình phương
Đích học
Tính tỷ lệ và số kỳ vọng, phân biệt risk ratio với odds ratio, chọn kiểm định theo cấu trúc đếm.
Ví dụ bảng 2 × 2
Trong bộ D giả định, 30 người ở mỗi nhóm được ghi nhận có/không hoàn tất khóa học. Các người độc lập; hai biến đều phân loại.
Tỷ lệ hoàn tất: A = 18/30 = 0,60; B = 10/30 = 0,333. Chênh lệch là 0,267, tức 26,7 điểm phần trăm. Tỷ số nguy cơ/tỷ lệ (risk ratio, RR) = 0,60/0,333 = 1,80. Odds A = 18/12 = 1,50; odds B = 10/20 = 0,50; OR = 3. OR = 3 không có nghĩa tỷ lệ hoàn tất gấp ba.
Theo H0 độc lập, số kỳ vọng mỗi ô = tổng hàng × tổng cột / tổng chung. Hai hàng đều có kỳ vọng 14 hoàn tất, 16 không hoàn tất. Pearson χ² = tổng (quan sát − kỳ vọng)²/kỳ vọng = 4,286, df = (2−1)(2−1) = 1, p = 0,0384. Kết quả này dùng Pearson không hiệu chỉnh liên tục; phần mềm dùng Yates có thể cho p khác, cần ghi rõ lựa chọn.
Một CI xấp xỉ Wald cho chênh lệch tỷ lệ dùng SE = √(0,6×0,4/30 + (1/3)×(2/3)/30) = 0,124; CI 95% ≈ [0,023; 0,510]. Đây là ví dụ tính tay; gần biên 0/1 hoặc mẫu nhỏ cần khoảng phù hợp hơn. Không suy rằng 26,7 điểm phần trăm là ước lượng chính xác chỉ vì p < 0,05.
Điều kiện và chuyển giao
Đếm số người, không đưa phần trăm vào phép χ² như thể là tần số. Kiểm tra số kỳ vọng, không chỉ số quan sát. Với bảng 2 × 2 thưa, cân nhắc Fisher exact; ngưỡng kỳ vọng 5 là hướng dẫn thực hành đơn giản, không phải định luật cho mọi bảng.
Nếu cùng người trả lời có/không trước và sau, các ô liên quan ghép cặp; kiểm định độc lập trên không phù hợp, cần phương pháp như McNemar. Nếu chỉ hỏi một tỷ lệ so với mốc, đó lại là bài một mẫu nhị thức.
Tự kiểm: “OR = 3 nên xác suất tăng 200%” sai ở đâu? Odds và xác suất có mẫu số khác nhau. Trong dữ liệu D, tỷ lệ tăng tương đối 80%, còn chênh lệch tuyệt đối 26,7 điểm phần trăm. Đọc bắt buộc: S13.
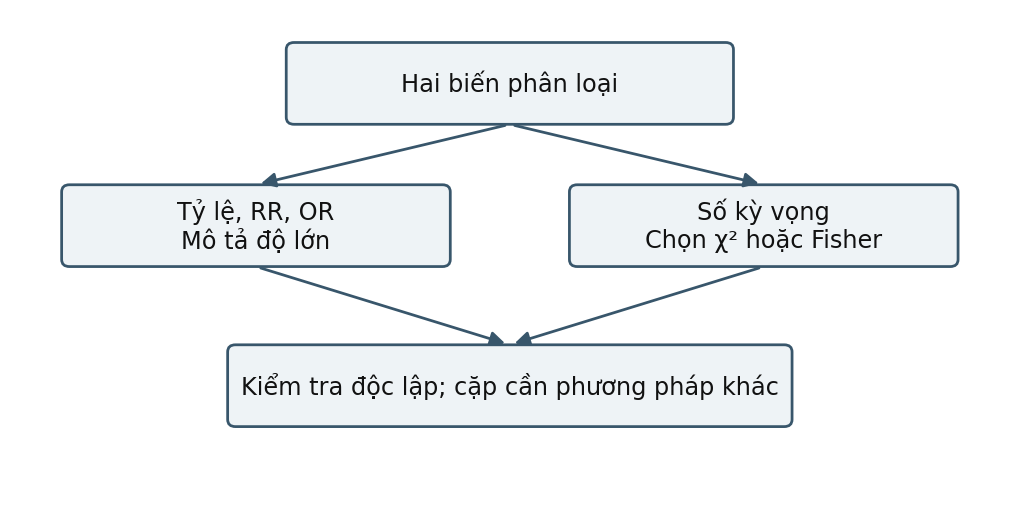
Hình 11. Sơ đồ đúc kết Chương 11, do giáo trình tổng hợp. Che hình, vẽ lại và giải thích mỗi mũi tên.
Chương 12. Phương pháp thứ hạng, ngoại lệ và dữ liệu thiếu
Đích học
Chọn phân tích độ nhạy theo vấn đề thực, hiểu phương pháp phi tham số vẫn có giả định và xử lý thiếu dữ liệu có minh bạch.
Không có phương pháp miễn giả định
Mann–Whitney so sánh thứ hạng giữa hai nhóm độc lập. Với điều kiện hình dạng phù hợp, có thể diễn giải về vị trí; nếu hai phân bố khác hình dạng, không đơn giản gọi nó là “kiểm định hai trung vị”. Wilcoxon signed-rank dành cho cặp cần xem đối xứng của phân bố chênh lệch để diễn giải như phép thử vị trí. Sign test dùng dấu, ít thông tin hơn nhưng không dùng độ lớn thay đổi theo cách signed-rank dùng.
Ví dụ sign test với A: 8/8 thay đổi dương, không có 0. Theo H0 dấu dương/âm có xác suất 0,5 và các người độc lập, p hai phía = 2×(1/2)⁸ = 0,0078125. Nó trả lời câu hỏi về cân bằng dấu, không giống t-test về trung bình. Không chọn phương pháp chỉ vì p của nó nhỏ hơn.
Permutation hoán đổi nhãn dựa trên khả năng trao đổi theo H0/thiết kế; bootstrap lấy lại mẫu có hoàn lại để xấp xỉ phân phối của thống kê. Cả hai cần tôn trọng đơn vị: dữ liệu cặp phải lấy lại cả cặp, dữ liệu phân cụm cần chiến lược phù hợp. Bootstrap từ 8 người không biến mẫu nhỏ thành thông tin tương đương 8.000 người.
Ba cơ chế thiếu dữ liệu cần hiểu
MCAR: thiếu không phụ thuộc giá trị quan sát và không quan sát trong mô hình xét. MAR: sau điều kiện trên thông tin đã quan sát, thiếu không còn phụ thuộc phần chưa quan sát. MNAR: phụ thuộc còn lại vào giá trị chưa quan sát. Đây là giả định về cơ chế, không phải nhãn chắc chắn có được từ một kiểm định.
Nếu người có kết quả thấp bỏ khảo sát, trung bình người trả lời có thể quá cao. Thay thiếu bằng 0 tạo một giá trị không được quan sát; thay bằng trung bình làm giảm biến thiên giả tạo. Phân tích cặp hoàn chỉnh, multiple imputation hoặc mô hình likelihood đều cần lý do và giả định, không có cách mặc định đúng mọi trường hợp.
Bài độ nhạy có đáp án
Giả sử A8 thiếu Sau, bảy Δ còn lại tổng 25 nên trung bình hoàn chỉnh = 25/7 = 3,571. Nếu giả định ΔA8 = −2, trung bình đủ 8 người thành 23/8 = 2,875; nếu ΔA8 = 3 thì bằng 3,50. Hai giá trị là kịch bản nhạy cảm, không được điền như dữ liệu thật rồi giấu giả định.
Ghi nhật ký: số thiếu, lý do biết được, phương pháp chính, kịch bản độ nhạy, thay đổi kết luận. Đọc đối chiếu: S17 về thứ hạng, S19 về thiếu dữ liệu và S14 về báo cáo; phần tính dấu và kịch bản thiếu là bài tự xây dựng.
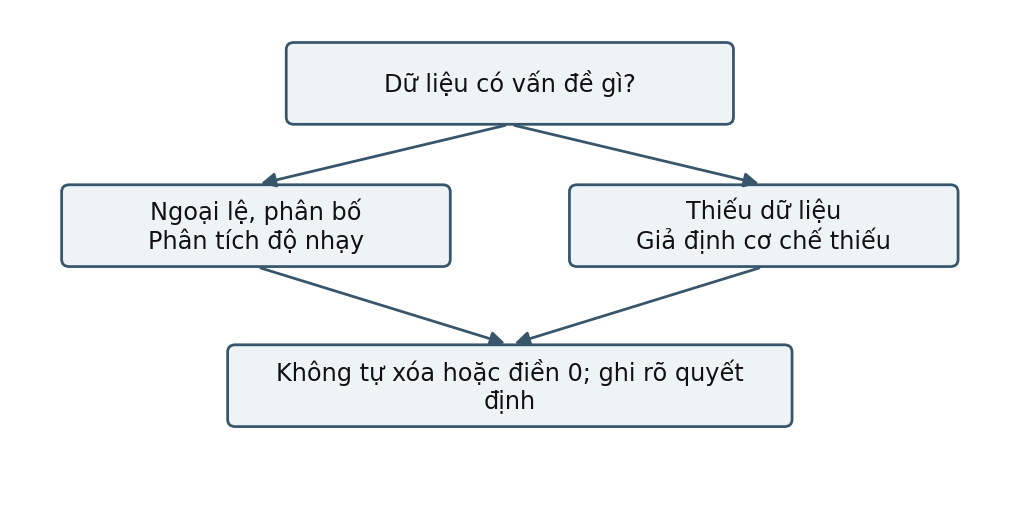
Hình 12. Sơ đồ đúc kết Chương 12, do giáo trình tổng hợp. Che hình, vẽ lại và giải thích mỗi mũi tên.
Chương 13. Cỡ mẫu, nhiều kiểm định và chất lượng phép đo
Đích học
Giải thích lý do cỡ mẫu, điều chỉnh nhiều phép thử và phân biệt độ tin cậy với tính giá trị của diễn giải điểm.
Cỡ mẫu phục vụ câu hỏi nào?
Trước thu thập, xác định mục tiêu ước lượng chính xác tới đâu hoặc muốn có power bao nhiêu cho hiệu ứng tối thiểu đáng quan tâm. Lakens trình bày nhiều cách biện minh cỡ mẫu; không phải nghiên cứu nào cũng có cùng một công thức hoặc cùng nguồn lực [S15]. Hãy ghi rõ giả định SD, hiệu ứng, α, power, mất mẫu và cấu trúc thiết kế.
Ví dụ lập kế hoạch sơ bộ cho trung bình: nếu σ xấp xỉ 10 và muốn sai số biên 95% khoảng 2, công thức chuẩn cho n ≈ (1,96×10/2)² = 96,04, làm tròn lên 97. Đây là xấp xỉ khi σ được giả định, chưa tính thiết kế cụm hay bất định của SD. Nếu dự kiến thu đủ dữ liệu ở 80% người tuyển, cần khoảng 97/0,8 = 121,25, làm tròn lên 122 người tuyển; con số không bảo đảm tỷ lệ hoàn tất thực tế.
Không dùng observed power tính từ hiệu ứng quan sát để “giải cứu” kết quả không có ý nghĩa. Sau nghiên cứu, đọc khoảng tin cậy và phân tích độ nhạy cho những hiệu ứng có ý nghĩa về nội dung.
Khi có nhiều kết quả
Nếu làm 20 phép thử độc lập, tất cả H0 đúng và mỗi phép có α = 0,05, xác suất ít nhất một dương tính giả là 1 − 0,95²⁰ ≈ 0,642. Sự độc lập ở đây là điều kiện của phép tính minh họa. Bonferroni chia α cho số phép thử trong họ kiểm định và vẫn kiểm soát family-wise error không cần độc lập; nó có thể bảo thủ. Holm là phương pháp tuần tự khác; FDR trả lời mục tiêu kiểm soát khác với xác suất có bất kỳ sai lầm nào.
Định trước kết quả chính và họ kiểm định. Ví dụ 5 kết quả cùng thuộc một họ, Bonferroni dùng 0,05/5 = 0,01. p = 0,03 không đạt quy tắc đó, nhưng ước lượng và khoảng tin cậy vẫn đáng báo cáo, không bị biến thành “không có thông tin”.
Điểm số tâm lý có đáng tin?
Độ tin cậy nói về tính nhất quán của điểm theo mô hình và điều kiện đo. Tính giá trị liên quan bằng chứng hỗ trợ cách diễn giải và sử dụng điểm. Alpha cao có thể đi cùng nhiều mục gần trùng hoặc nhiều chiều; không đủ chứng minh thang đo đơn hướng hay phù hợp chẩn đoán. Omega và phân tích nhân tố cần mô hình và đánh giá thích hợp, sẽ được học sâu ở EPSY111.
Tự kiểm: tăng n sửa được sai lệch hệ thống của thang đo không? Không; có thể chỉ ước lượng rất chính xác một đại lượng đo sai. Bài chương: viết 120 từ biện minh n cho một khảo sát, ghi điều nào là dữ kiện, điều nào là giả định. Đọc bắt buộc: S15; cầu nối đo lường tham chiếu S16.
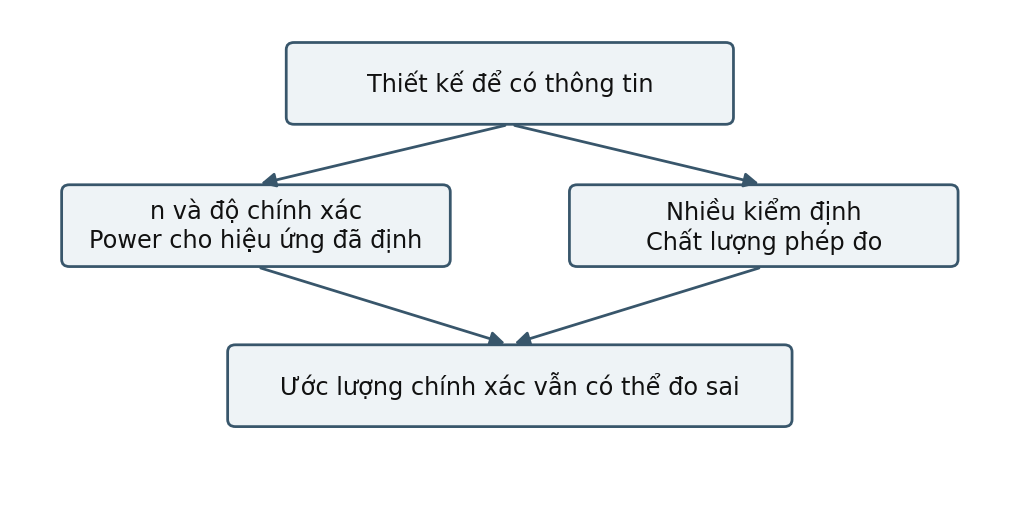
Hình 13. Sơ đồ đúc kết Chương 13, do giáo trình tổng hợp. Che hình, vẽ lại và giải thích mỗi mũi tên.
Chương 14. Từ đầu ra phần mềm tới báo cáo có thể kiểm tra
Đích học
Hoàn thiện chuỗi phân tích, báo cáo kết quả và đánh giá mức chắc chắn của kết luận.
Quy trình thực hành
Giữ bản dữ liệu gốc. Tạo bản phân tích với từ điển biến và nhật ký xử lý. Kiểm tra trùng ID, đơn vị, miền giá trị, số thiếu, nhóm và thời điểm. Chốt tham số đích và phương pháp trước khi thử nhiều cách. Vẽ dữ liệu, kiểm tra điều kiện, tính ước lượng, CI và phép kiểm định đã định. Lưu cả các phân tích khám phá và lý do thay đổi.
Trong phần mềm thống kê, xác định biến kết quả, biến nhóm, ID ghép cặp và mức tin cậy. Kiểm tra số quan sát thực sự được dùng trong đầu ra. Đừng mặc định nhãn “t-test” nghĩa là Welch; đừng mặc định phần mềm giữ nguyên mọi hàng có thiếu. Các bước này dùng được với nhiều phần mềm mà không phụ thuộc vị trí nút.
Mẫu báo cáo tích hợp cho A–B
“Trong dữ liệu giả định gồm 16 người, biến chính là thay đổi số nhiệm vụ hoàn tất sau 4 tuần. Phân tích đã chọn so sánh hai nhóm độc lập bằng Welch trên điểm thay đổi. Nhóm A có MΔ = 3,50, SDΔ = 1,60, n = 8; nhóm B có MΔ = 0,75, SDΔ = 1,04, n = 8. Chênh lệch A − B = 2,75 nhiệm vụ, CI 95% [1,28; 4,22], t(11,97) = 4,08, p = 0,002. Không có thiếu dữ liệu trong bộ minh họa. Kết quả cần được đọc với giả định độc lập và xấp xỉ t ở mẫu nhỏ. Chưa đủ chắc chênh lệch vượt mức thực tế 3 nhiệm vụ vì CI còn chứa các giá trị dưới mức này.”
Nếu báo cáo nghiên cứu thật, cần bổ sung cách tuyển mẫu, phân nhóm, thực hiện can thiệp, kiểm tra phân bố, lý do cỡ mẫu, quy tắc thiếu dữ liệu và mọi phân tích khác. Không viết “đã kiểm tra giả định và đều đạt” nếu chưa thực hiện, hoặc xem kiểm định chuẩn không ý nghĩa là bằng chứng giả định chắc chắn đúng. JARS của APA hỗ trợ cấu trúc báo cáo minh bạch [S14].
Bảng tự kiểm trước nộp
Tự làm: viết báo cáo bộ D trong 150 từ, thêm một giới hạn lấy mẫu và một giới hạn mô hình. Đáp án cần có 60% so với 33,3%, chênh lệch 26,7 điểm phần trăm, χ²(1) = 4,29, p = 0,038 và giải thích không suy nhân quả từ riêng bảng đếm.
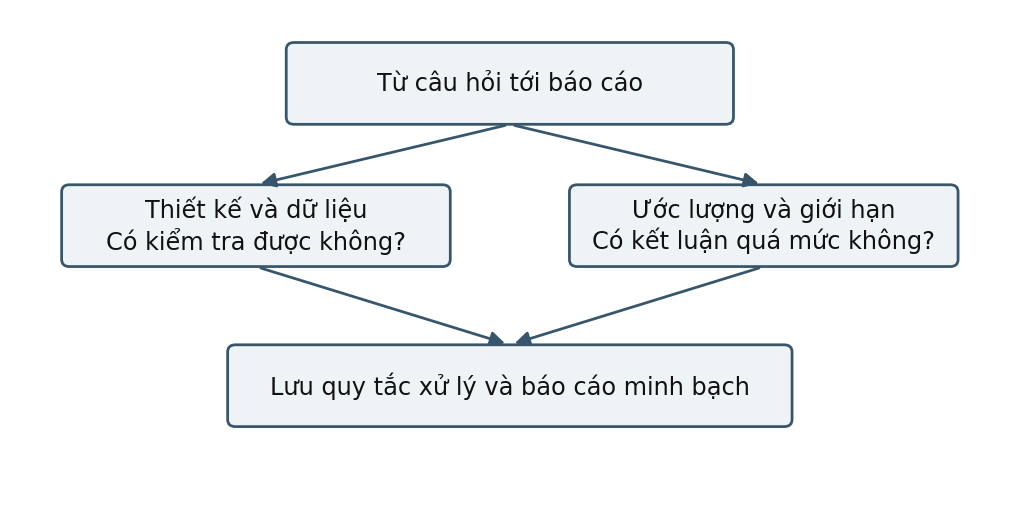
Hình 14. Sơ đồ đúc kết Chương 14, do giáo trình tổng hợp. Che hình, vẽ lại và giải thích mỗi mũi tên.
Sơ đồ toàn môn và bảng chọn phương pháp
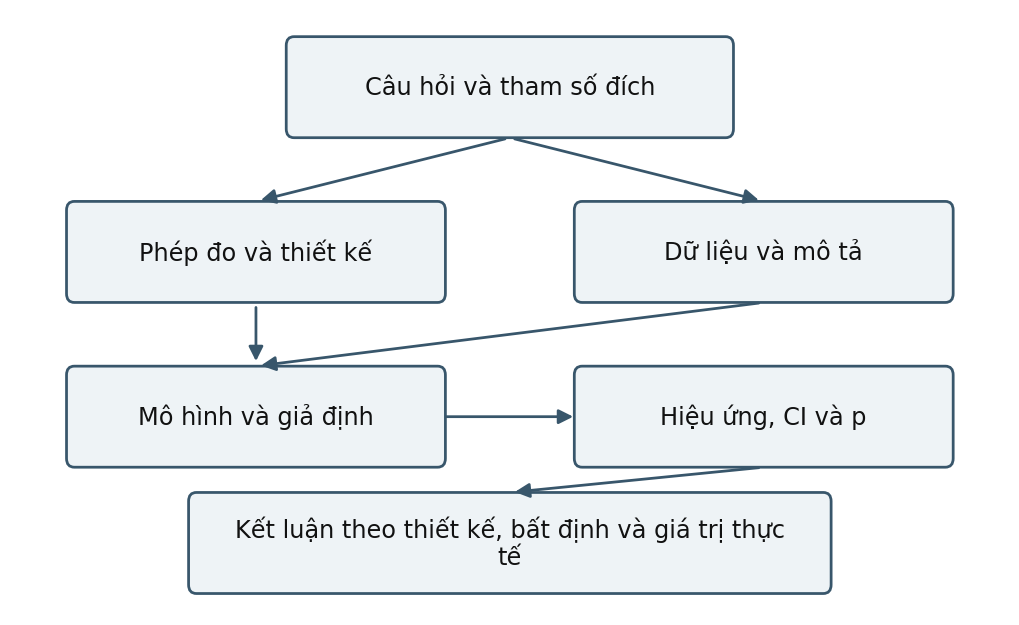
Hình 15. Bản đồ toàn môn. Sơ đồ do giáo trình xây dựng; có thể quay lại sửa câu hỏi khi nhận ra giới hạn.
Đọc sơ đồ từ câu hỏi xuống dữ liệu rồi kết luận. Khi kết luận có vẻ quá mạnh, lần ngược về thiết kế, phép đo và mẫu. p chỉ là một thành phần của bước suy luận; không thay được chất lượng các bước trước đó.
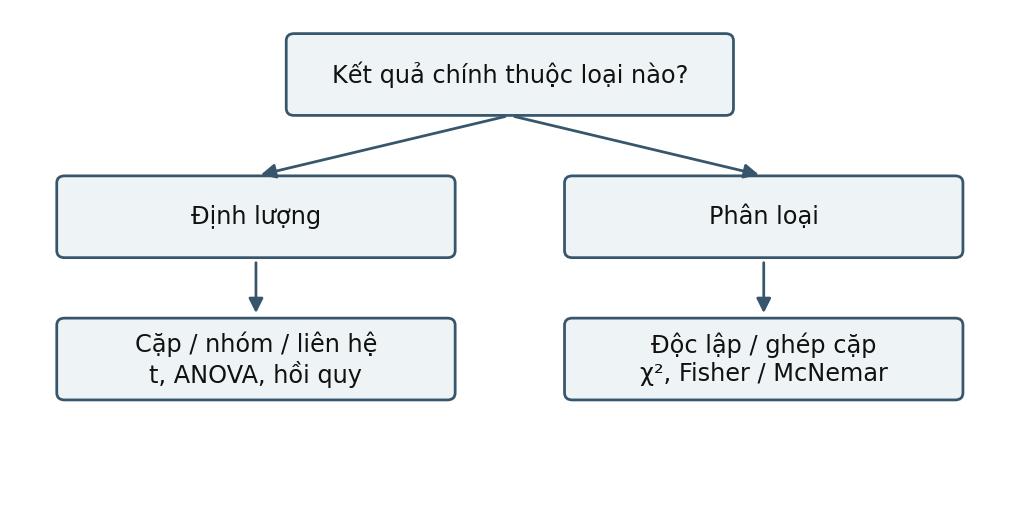
Hình 16. Bước đầu chọn phương pháp. Dùng cùng bảng điều kiện; dữ liệu cụm hoặc đo lặp phức tạp cần mô hình riêng.
Bài luyện sơ đồ 5 phút: chọn một dòng bảng, che cột phương pháp và điều kiện, tự điền lại. Sau đó tạo một tình huống khiến lựa chọn ban đầu không còn đúng, thí dụ đổi “hai nhóm độc lập” thành “cùng người đo hai lần”. Nếu chỉ nhớ tên phép thử mà không đổi được quyết định, hãy ôn lại cấu trúc dữ liệu.
Bốn chuyên đề cầu nối thạc sĩ
Chuyên đề A. Ước lượng, tương đương và quyết định
Mục tiêu: phân biệt “khác 0” với “đủ lớn” và “tương đương trong giới hạn”. Dùng kết quả chênh lệch 2,75, CI [1,28; 4,22]. Nếu ngưỡng đáng quan tâm là 3 nhiệm vụ, hãy giải thích tại sao chưa chắc vượt ngưỡng. Nếu biên tương đương đã định là [−1; 1], kết quả này cũng không chứng minh tương đương.
Sản phẩm: một trang phân biệt superiority, equivalence và non-inferiority bằng mục tiêu và biên có trước dữ liệu. Với TOST ở α = 0,05, quy tắc CI thường dùng CI 90% nằm hoàn toàn trong biên tương đương; phải dùng đúng mô hình và biên đã biện minh, không tự thay mọi CI 95% bằng một kết luận tương đương. Chuyên đề này là định hướng đọc tiếp theo S18, chưa thay cho học chuyên sâu.
Chuyên đề B. Hồi quy có điều chỉnh và dữ liệu phân cụm
Mục tiêu: nhận biết khi phân tích đơn giản không đủ. Với dữ liệu trước–sau trong thử nghiệm, cân nhắc mô hình điểm sau theo nhóm và điểm trước (ANCOVA), giải thích giả định và tham số nhóm. Nếu can thiệp phân theo 10 đội, nhân viên trong đội chia sẻ điều kiện; cần xử lý cụm, và chỉ 10 cụm là thách thức suy luận riêng.
Sản phẩm: vẽ cấu trúc người trong đội, viết phương trình bằng lời, nêu điều kiện mà mô hình độc lập bị sai. Không chọn mô hình nhiều tầng chỉ để tạo cảm giác nâng cao; lựa chọn dựa cấu trúc và mục tiêu. Đọc tiếp Penn State STAT 501 [S11a–S11b].
Chuyên đề C. Độ nhạy, thiếu dữ liệu và khả năng tái lập
Mục tiêu: phân biệt phân tích chính được định trước với phân tích kiểm tra độ bền. Viết trước ba kịch bản: điểm ngoại lệ là thật; một nhóm mất người nhiều hơn; kết quả phụ không đạt sau điều chỉnh bội. Dự đoán mỗi kịch bản có thể đổi ước lượng, SE hoặc giới hạn kết luận ra sao.
Sản phẩm: phụ lục 600 từ với bảng quyết định xử lý và lý do. Đừng liệt kê hàng chục phương án rồi chỉ báo cáo phương án đẹp nhất. Kết quả không đồng nhất giữa phương án hợp lý là thông tin về độ nhạy cần công khai [S14].
Chuyên đề D. Phản biện một nghiên cứu định lượng
Chọn một bài thực nghiệm tâm lý có toàn văn và phụ lục mở. Trích đúng nguồn bài đã chọn; không dùng bản tóm tắt để đoán những phương pháp không được cung cấp. Ghi câu hỏi, tham số đích, mẫu, phép đo, thiết kế, mô hình, ước lượng, bất định, dữ liệu thiếu, tính minh bạch và phạm vi khái quát.
Sản phẩm: 1.000 từ, ít nhất hai điểm mạnh và hai giới hạn gắn với kết luận cụ thể. Chấm theo: đúng nội dung 40%, logic suy luận 30%, bằng chứng nguồn 20%, trình bày 10%. Câu “mẫu nhỏ nên nghiên cứu vô giá trị” chưa đạt; hãy nói mẫu nhỏ ảnh hưởng điều gì và CI cho phép loại trừ/giữ lại những hiệu ứng nào.
Kiểm tra giữa môn và bài cuối môn
Giữa môn • 60 phút • 100 điểm
Không xem lời giải trong khi làm. Được dùng máy tính cơ bản; mỗi câu phải có diễn giải bằng lời. Chỉ tính đúng nhưng không xác định câu hỏi tối đa nhận một nửa điểm câu.
G1 (20 điểm). Bộ Δ = 1, 2, 3, 4, 5. Tính M, phương sai mẫu, SD và SE. Phân biệt ý nghĩa SD/SE bằng một câu.
G2 (25 điểm). Với bộ G1, lập CI 95% cho trung bình, dùng t tới hạn df = 4 là 2,776. Diễn giải đúng và nêu hai điều kiện áp dụng.
G3 (25 điểm). Mười hai người được đo hai lần. Chọn phân tích khi quan tâm thay đổi trung bình; giải thích vì sao không coi là 24 người độc lập. Nếu một người thiếu lần sau, cần ghi điều gì?
G4 (30 điểm). Một báo cáo viết “p = 0,08 nên chương trình vô hiệu; nhóm A có p = 0,04, nhóm B có p = 0,20 nên A chắc chắn tốt hơn B”. Chỉ ra hai lỗi và viết lại kết luận hợp lý.
Cuối môn • 90 phút • 100 điểm
Phần trắc nghiệm 24 câu, mỗi câu 2 điểm, tổng 48 điểm. Chọn một đáp án tốt nhất. Phần tự luận 52 điểm ở sau. Các câu hỏi do giáo trình xây dựng, không phải đề chính thức của trường.
01. ID nhân viên được mã bằng số. Có nên lấy trung bình ID?
A. Chỉ khi SD nhỏ
B. Không, đó là biến định danh
C. Có, nếu n trên 30
D. Có, vì mọi số đều định lượng
02. Một người được đo 5 lần. Điều gì cần kiểm tra trước suy luận?
A. p có nhỏ hơn 0,05 không
B. Chỉ màu biểu đồ
C. Có đúng 5 cột không
D. Tính phụ thuộc giữa các lần đo
03. Chỉ số nào mô tả độ phân tán cá nhân trên đơn vị gốc?
A. SE của trung bình
B. SD
C. df
D. p
04. Giữ SD cố định và các quan sát độc lập, tăng n gấp 4 làm SE trung bình thế nào?
A. Tăng hai lần
B. Giảm bốn lần
C. Giảm một nửa
D. Không đổi
05. Khoảng tin cậy 95% cho trung bình không có nghĩa gì?
A. Có thể dùng để xem độ chính xác
B. 95% cá nhân nằm trong khoảng đó
C. Được tạo theo một quy trình có mức bao phủ
D. Phụ thuộc giả định mô hình
06. p = 0,04 cho phép nói điều gì?
A. H0 có xác suất đúng 4%
B. Tác động chắc chắn lớn
C. Can thiệp có hiệu quả với 96% người
D. Dữ liệu tương đối không phù hợp với H0 theo mô hình đã chọn
07. Không bác bỏ H0 có đồng nghĩa hai cách tương đương?
A. Có, luôn luôn
B. Có, nếu SD bằng nhau
C. Không, cần đánh giá biên và phương pháp tương đương
D. Có, nếu p trên 0,10
08. Để so trung bình trước–sau của cùng người, bước chính của t ghép cặp là gì?
A. Chỉ so hai SD
B. Tạo điểm chênh lệch từng người
C. Ghép ngẫu nhiên lại người
D. Gộp hai lần đo thành mẫu độc lập
09. Trong t ghép cặp mẫu nhỏ, giả định phân bố cần xét chủ yếu ở đâu?
A. Mã ID
B. Các điểm chênh lệch
C. Chỉ điểm trước
D. Chỉ điểm sau
10. Welch t giải quyết yêu cầu nào của t gộp?
A. Cho phép suy nhân quả tự động
B. Không cần độc lập
C. Không cần giả định hai phương sai bằng nhau
D. Không cần quan tâm ngoại lệ
11. A có p = 0,02, B có p = 0,20 trong hai kiểm định riêng. Kết luận nào đúng?
A. Chưa đủ để kết luận A khác B
B. Hiệu ứng A gấp 10 lần B
C. B không có tác động
D. A chắc chắn khác B
12. ANOVA có ý nghĩa cho biết điều gì về ba trung bình?
A. Ít nhất một trung bình khác theo mô hình
B. Nhóm lớn nhất luôn hơn cả hai nhóm kia
C. Mọi cặp đều khác
D. Phương sai bằng nhau
13. Hiệu quả học tăng 4 điểm ở người mới, 1 điểm ở người có kinh nghiệm là dấu hiệu mô tả của gì?
A. Tương tác
B. Mất mẫu ngẫu nhiên
C. Sai số loại I đã xác nhận
D. Độ tin cậy
14. Pearson r gần 0 có loại trừ mọi liên hệ không?
A. Có, nếu n lớn
B. Không, có thể có dạng chữ U
C. Có, mọi trường hợp
D. Có, nếu hai biến là số
15. Spearman chủ yếu mô tả gì?
A. Tác động nhân quả
B. Mọi quan hệ phi tuyến
C. Liên hệ đơn điệu qua thứ hạng
D. Chênh lệch trung bình
16. Trong hồi quy, phần dư bằng gì?
A. Dự đoán trừ trung bình X
B. Hệ số dốc chia n
C. Bình phương tương quan
D. Giá trị quan sát trừ dự đoán
17. Giả định chuẩn để suy luận hồi quy mẫu nhỏ liên quan tới gì?
A. X bắt buộc chuẩn riêng
B. Y bắt buộc chuẩn riêng
C. Sai số có điều kiện trong mô hình
D. Tất cả biến phải là điểm z
18. Ô bảng chéo có tổng hàng 30, tổng cột 28, tổng chung 60. Kỳ vọng bằng bao nhiêu?
A. 14
B. 60
C. 28
D. 30
19. A hoàn tất 18/30, B hoàn tất 10/30. RR bằng bao nhiêu?
A. 1,8
B. 2,8
C. 3
D. 0,267
20. Cùng người trả lời có/không trước–sau, nên nhận diện điều gì?
A. Dữ liệu nhị phân ghép cặp
B. Hai biến liên tục
C. Hai mẫu độc lập mặc định
D. ANOVA cổ điển là lựa chọn bắt buộc
21. Mann–Whitney luôn là kiểm định hai trung vị đúng không?
A. Đúng trong mọi phân bố
B. Đúng nếu dữ liệu mã bằng số
C. Không, diễn giải vị trí cần điều kiện về hình dạng
D. Đúng chỉ vì n nhỏ
22. Vì sao không thay mọi giá trị thiếu bằng 0?
A. Vì làm n nhỏ hơn
B. Vì 0 luôn là ngoại lệ
C. Vì phần mềm không nhận 0
D. 0 là giá trị quan sát cụ thể, không phải thiếu
23. Năm phép thử thuộc một họ, Bonferroni ở mức 0,05 dùng ngưỡng nào?
A. 0,25
B. 0,10
C. 0,05
D. 0,01
24. Alpha cao tự chứng minh điều gì dưới đây?
A. Điểm chắc chắn dùng chẩn đoán được
B. Không có sai số đo
C. Thang đo chắc chắn đơn hướng
D. Không tự chứng minh đơn hướng hay tính giá trị
Phần tự luận cuối môn
T1 (18 điểm). Từ bộ A–B, xác định tham số đích, chọn phép so sánh, báo cáo chênh lệch và CI. Đánh giá phát biểu “chương trình chắc chắn tăng hơn 3 nhiệm vụ so với đối chiếu”.
T2 (16 điểm). Với bộ C, tính dự đoán tại X = 4, phần dư tại quan sát đó, giải thích b và R². Nêu hai lý do không suy nhân quả.
T3 (18 điểm). Với bộ D, tính tỷ lệ hai nhóm, chênh lệch điểm phần trăm, RR và OR. Giải thích vì sao OR khác RR và viết một câu báo cáo χ² với phương pháp cụ thể.
Đáp án, thang chấm và sửa lỗi
Đáp án giữa môn
G1: M = 3; tổng bình phương độ lệch = 10; s² = 10/4 = 2,5; SD = 1,581; SE = 1,581/√5 = 0,707. Chia điểm: M 4, s² 4, SD 4, SE 4, phân biệt đúng ý nghĩa 4.
G2: biên = 2,776×0,707 ≈ 1,963; CI [1,037; 4,963]. Điểm: công thức 5, thế số/kết quả 8, diễn giải về trung bình và quy trình tin cậy 7, độc lập và giả định phân bố mẫu nhỏ 5.
G3: t ghép cặp trên chênh lệch, kiểm tra phân bố chênh lệch và độc lập giữa người. Mười hai người là 12 cặp nếu đủ dữ liệu. Khi thiếu một lần sau, ghi n đủ cặp, lý do thiếu, phương pháp xử lý và giới hạn có thể thiên lệch. Điểm: phương pháp 8, cấu trúc 8, xử lý thiếu minh bạch 9.
G4: không bác bỏ H0 không chứng minh vô hiệu; khác trạng thái ý nghĩa của hai p không chứng minh chênh lệch giữa nhóm. Cần CI, hiệu ứng và kiểm định trực tiếp chênh lệch A−B; để kết luận tương đương cần biên và phương pháp riêng. Mỗi lỗi 10 điểm, kết luận sửa hợp lý 10 điểm.
Đáp án trắc nghiệm và lý do
01. B. Mã số nhận diện không mang ý nghĩa lượng đo.
02. D. Đo lặp chia sẻ đặc điểm của cùng người; phải phản ánh phụ thuộc.
03. B. SD mô tả độ phân tán của các giá trị, còn SE mô tả độ bất định của thống kê.
04. C. SE = SD/√n nên căn của 4 là 2.
05. B. Khoảng cho tham số trung bình khác khoảng mô tả cá nhân.
06. D. p là xác suất của dữ liệu/thống kê cực đoan theo mô hình H0, không là xác suất giả thuyết.
07. C. Không đủ bằng chứng khác biệt không chứng minh tương đương.
08. B. Kiểm định trung bình của các chênh lệch giữ cấu trúc cặp.
09. B. t áp dụng lên chênh lệch nên cần kiểm tra phân bố d và độc lập giữa người.
10. C. Welch điều chỉnh SE/df cho phương sai khác nhau nhưng không sửa mọi vi phạm.
11. A. Cần kiểm định trực tiếp chênh lệch A−B.
12. A. Kiểm định chung không xác định từng cặp.
13. A. Hiệu ứng của phương pháp thay đổi theo mức kinh nghiệm; còn cần dữ liệu để suy luận thống kê.
14. B. Pearson tóm tắt liên hệ tuyến tính, có thể bỏ qua quan hệ phi tuyến.
15. C. Spearman dùng thứ hạng và phù hợp liên hệ đơn điệu.
16. D. Phần dư là sai lệch của quan sát so với giá trị fitted.
17. C. Kiểm tra phần dư để đánh giá giả định về sai số, không đòi mọi biến gốc đều chuẩn.
18. A. 30×28/60 = 14 theo H0 độc lập.
19. A. RR = (18/30)/(10/30) = 1,8. OR của bảng này mới bằng 3.
20. A. Cấu trúc cặp gợi ý phương pháp như McNemar, không χ² độc lập thông thường.
21. C. Phân bố khác hình dạng khiến diễn giải đơn thuần về trung vị không phù hợp.
22. D. Điền 0 áp đặt thông tin không có và có thể làm sai ước lượng.
23. D. 0,05/5 = 0,01 cho từng phép trong họ.
24. D. Độ tin cậy và bằng chứng giá trị cần đánh giá theo mô hình và mục đích dùng.
Gợi ý chấm tự luận cuối môn
T1: tham số chênh lệch mức thay đổi trung bình A−B (4); Welch trên Δ vì hai nhóm người độc lập (4); 2,75, CI [1,28; 4,22], t(11,97) = 4,08, p = 0,002 (6); chưa chắc vượt 3 và nêu giới hạn mô hình/mẫu (4).
T2: Ŷ = 5,429 và phần dư = 0,571 (6); b mô tả tăng trung bình dự đoán 0,857 mỗi phiên trong mô hình (3); R² = 0,804 là mức phù hợp trong mẫu, không tỷ phần nhân quả (3); hai giải thích như nhiễu và chiều ngược (4).
T3: tỷ lệ 60%/33,3% (4); chênh lệch 26,7 điểm phần trăm (3); RR = 1,80, OR = 3 (4); odds dùng số không hoàn tất làm mẫu số còn tỷ lệ dùng tổng (3); Pearson không hiệu chỉnh χ²(1) = 4,29, p = 0,038 (4).
Báo cáo tích hợp • 1.200–1.500 từ
Dùng A–B hoặc một bộ dữ liệu được phép sử dụng có từ điển biến. Nộp câu hỏi, tham số đích, mô tả mẫu/thiết kế, bảng mô tả, một biểu đồ, phân tích chính, kiểm tra điều kiện, kết luận và giới hạn. Nếu dùng dữ liệu thật, không đưa thông tin định danh vào bài học chia sẻ.
Sau chấm, ghi ba lỗi vào sổ: “Tôi đã nghĩ gì?”, “Vì sao sai?”, “Bài mới nào kiểm tra được tôi đã sửa?”. Làm lại bài sai sau 48 giờ mà không nhìn đáp án, rồi làm một tình huống khác sau một tuần. Nếu sai ở cấu trúc cặp/độc lập, quay lại Chương 1, 6 và 7; nếu sai ở p/CI, quay lại Chương 4–5.
Bảng tra nhanh và thuật ngữ
Công thức bằng lời để truy hồi
Trung bình = tổng giá trị / n. Phương sai mẫu = tổng bình phương độ lệch khỏi trung bình / (n−1). SD = căn phương sai. Với trung bình của quan sát độc lập: SE = SD/√n.
Khoảng t cho một trung bình = M ± t tới hạn × SE; df = n−1. Với cặp, thực hiện trên d. Với Welch, SE chênh lệch = √(sA²/nA + sB²/nB), sử dụng df Welch.
F một yếu tố = MS giữa/MS trong. Pearson r = tổng tích độ lệch / căn của tích hai tổng bình phương độ lệch. Đường hồi quy đơn có chặn: Ŷ = a + bX. Phần dư = Y − Ŷ.
Kỳ vọng ô bảng chéo = tổng hàng × tổng cột/tổng chung. χ² Pearson = tổng của (quan sát − kỳ vọng)²/kỳ vọng. RR dùng tỷ lệ; OR dùng odds. Các công thức chỉ có ý nghĩa khi điều kiện áp dụng phù hợp.
Tài liệu tham khảo và đường đọc
Các mã S dẫn tới nguồn cụ thể dưới đây; những ví dụ số, câu hỏi và sơ đồ là phần biên soạn độc lập. Ngày đối chiếu: 12/10/2026. Một số trang Penn State được xác minh qua chỉ mục tìm kiếm khi truy xuất toàn trang gặp lỗi; không xem đó là xác nhận đã đọc toàn bộ khóa học. Tên nguồn chỉ biểu thị tham chiếu học thuật, không phải bảo chứng cho tài liệu này.
S01. Penn State, Department of Statistics. STAT 200: Elementary Statistics. Tổng quan học phần. Dùng đối chiếu phạm vi nhập môn: mô tả, suy luận, CI và kiểm định.
S02. UCLA, Office of Advanced Research Computing. Choosing the Correct Statistical Test in SAS, Stata, SPSS and R. Bảng lựa chọn phương pháp. Dùng tham khảo đường chọn; vẫn cần kiểm tra thiết kế và điều kiện.
S03. OpenStax, Rice University. Introductory Statistics 2e, Chapter 2: Descriptive Statistics. Mở chương mô tả. Đọc về trung tâm, độ phân tán và trình bày dữ liệu; ví dụ trong tài liệu này không sao chép bài tập nguồn.
S04. OpenStax. Introductory Statistics 2e, §7.1: The Central Limit Theorem for Sample Means. Mở bài phân phối lấy mẫu. Đọc phân biệt phân bố cá nhân với phân phối trung bình.
S05. Penn State. STAT 200, Lesson 4: Confidence Intervals. Mở bài khoảng tin cậy. Đọc ý nghĩa độ tin cậy và độ chính xác.
S06. American Statistical Association. (2016, March 7). Statement release on Statistical Significance and P-Values. Văn bản ASA. Nguồn cho các nguyên tắc diễn giải p ở Chương 5.
S07. NIST. Dataplot Reference Manual: T TEST. Công thức một mẫu, độc lập và ghép cặp. Dùng đối chiếu cấu trúc phép t và điểm chênh lệch.
S08. Penn State. STAT 200, Lesson 8: Inference for One Sample. Mở bài một mẫu và cặp. Đường đọc bổ sung cho Chương 4 và 6.
S09. NIST/SEMATECH e-Handbook of Statistical Methods. §1.3.5.3: Two-Sample t-Test for Equal Means. Mở công thức Welch. Đối chiếu SE và df Welch–Satterthwaite.
S10. MIT OpenCourseWare. (2015). 18.443 Statistics for Applications, Lecture 16: Analysis of Variance. Bài giảng ANOVA. Đọc logic kiểm định chung và phân rã biến thiên.
S11a. Penn State. STAT 501, Lesson 1: Simple Linear Regression. Mở bài hồi quy đơn. Dùng nối tương quan, hệ số và dự đoán.
S11b. Penn State. STAT 501, Lesson 4: SLR Model Assumptions. Mở bài giả định hồi quy. Đọc kiểm tra giả định thông qua phần dư.
S12. Institute of Education Sciences. (2007). Organizing Instruction and Study to Improve Student Learning. Hướng dẫn thực hành. Tham chiếu truy hồi, giãn cách, ví dụ mẫu và kết hợp hình với giải thích; không chứng nhận “kiểu học” V–Ad.
S13. Penn State. STAT 200, Lesson 11: Chi-Square Tests. Mở bài bảng chéo. Đọc số kỳ vọng và kiểm định độc lập.
S14. American Psychological Association. APA Style Journal Article Reporting Standards. Mở JARS. Dùng đối chiếu nội dung báo cáo nghiên cứu; bài học chọn những mục liên quan trình độ hiện tại.
S15. Lakens, D. (2022). Sample Size Justification. Collabra: Psychology, 8(1), 33267. Bài gốc, DOI; hồ sơ công trình tại Eindhoven University of Technology. Đọc cách biện minh n theo mục tiêu suy luận.
S16. Coefficient α as a Measure of Test Score Reliability: Review of 3 Popular Misconceptions. (2016). Toàn văn bài nghiên cứu phương pháp. Đọc giới hạn alpha trước khi chuyển sang EPSY111; bài này không được dùng như hướng dẫn chẩn đoán cá nhân.
S17. Penn State. STAT 415, Lesson 20: The Wilcoxon Tests. Mở bài Wilcoxon. Đối chiếu giả định đối xứng và vai trò thứ hạng trong Chương 12.
S18. Lakens, D. Improving Your Statistical Inferences, Chapter 9: Equivalence Testing and Interval Hypotheses. Mở bài kiểm định tương đương. Nguồn đọc tiếp cho chuyên đề A.
S19. UCLA OARC. Advanced Topics in Survey Data Analysis, mục Handling of missing data. Học liệu về dữ liệu thiếu. Đọc ba cơ chế thiếu và ảnh hưởng của thiết kế khảo sát; không cần học lệnh phần mềm để hoàn thành phần nền tảng.
Học phần kế tiếp
EPSY111 – Trắc nghiệm và chẩn đoán tâm lý: điểm số, chuẩn hóa, độ tin cậy, bằng chứng giá trị, công bằng đo lường và giới hạn diễn giải. Điều kiện sẵn sàng: giải thích được SD/SE, tương quan, CI, phân tích nhân tố ở mức mục tiêu và vì sao alpha không đủ bảo đảm phép đo có giá trị. Phân tích nhân tố sẽ được giới thiệu trong học phần mới; chưa yêu cầu tính ở EPSY205.